標準偏差と標準誤差の違いとは?n-1で割る理由・相対標準偏差と変動係数
同じ塩酸を 10.00 mL ずつ取り、水酸化ナトリウム水溶液で5回滴定しました。滴定量は 12.46、12.52、12.49、12.41、12.47 mL。平均は 12.47 mL です。レポートには「12.47 ± 0.04 mL」と書くべきでしょうか、それとも「12.47 ± 0.02 mL」でしょうか。実は、どちらも同じ5つの数字から正しく計算した値です。前者が標準偏差、後者が標準誤差で、± の後ろの数字が表しているものがまったく違います。
この2つを取り違えると、誤差棒の長さが2倍以上変わり、「差がある・ない」の判断まで変わってしまいます。この記事では、上の滴定データを最後まで使い回しながら、標準偏差の計算、n ではなく n−1 で割る理由、標準誤差が √n で小さくなる理由、信頼区間、そして相対標準偏差(変動係数)までを、式の「なぜ」から組み立てます。
標準偏差と標準誤差の違い(先に一覧で)
先に全体像を表にまとめます。数値は冒頭の滴定5回(n=5)から計算した値で、計算の中身はこのあと1つずつ説明します。
| 量 | 何のばらつきか | 式 | n を増やすと | 滴定5回の値 |
|---|---|---|---|---|
| 標準偏差 s(SD) | 1回1回の測定値 | √[Σ(x − x)2 ÷ (n − 1)] | 小さくならない(測定法のばらつきに近づく) | 0.041 mL |
| 標準誤差(SE) | 平均値 | s ÷ √n | √n に反比例して小さくなる | 0.018 mL |
| 95%信頼区間の半幅 | 平均値(真の平均 μ がありそうな範囲) | t × s ÷ √n | SE より速く小さくなる(t も小さくなる) | 0.050 mL(t=2.776) |
| 相対標準偏差(RSD)=変動係数(CV) | 測定値(平均に対する割合) | s ÷ x(×100 で %) | 小さくならない | 0.33% |
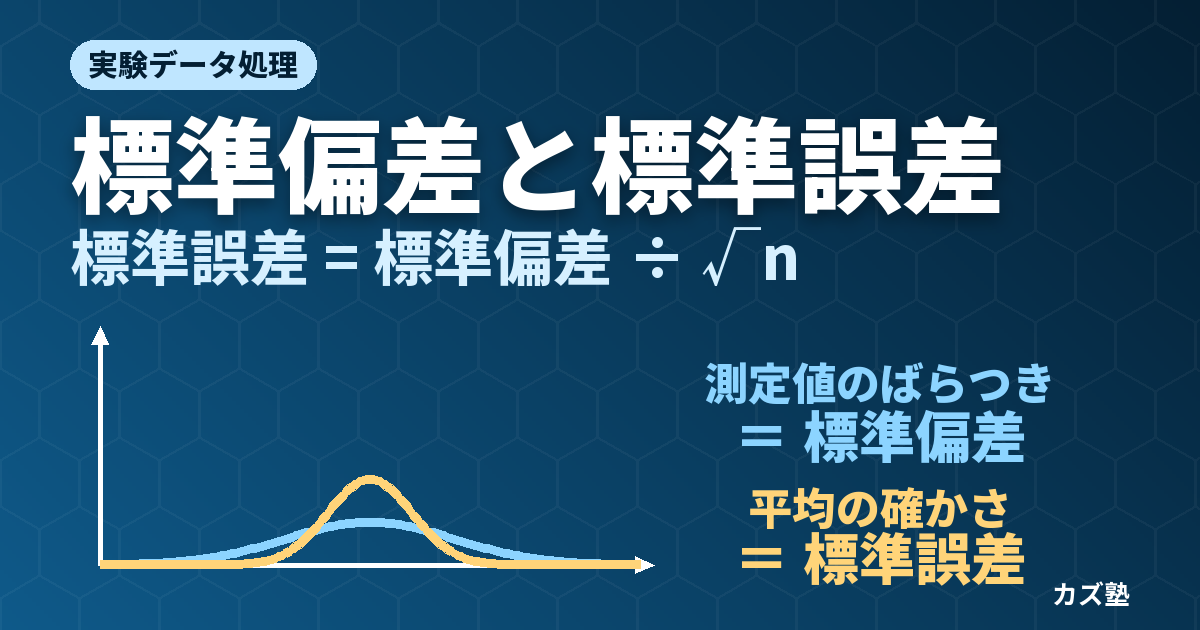
表の中の x(エックスバー)は平均値を表す記号です。覚えるべき関係は1つだけで、標準誤差=標準偏差 ÷ √n です。残りは、この関係が「なぜ」成り立つのかを理解すれば、自然に使い分けられるようになります。
標準偏差の計算:滴定5回のデータで
平均・偏差・平方和
まず平均値 x を求め、各測定値が平均からどれだけ離れているか(偏差)を計算します。
| 回 | 滴定量 x(mL) | 偏差 x − x(mL) | 偏差の2乗(mL2) |
|---|---|---|---|
| 1 | 12.46 | −0.01 | 0.0001 |
| 2 | 12.52 | +0.05 | 0.0025 |
| 3 | 12.49 | +0.02 | 0.0004 |
| 4 | 12.41 | −0.06 | 0.0036 |
| 5 | 12.47 | 0.00 | 0.0000 |
| 合計 | 62.35(平均 12.47) | 0 | 0.0066(平方和) |
偏差の合計がちょうど 0 になっていることに注目してください。これは偶然ではなく、平均値の定義そのものから必ずそうなります(平均値は「プラスの偏差とマイナスの偏差がつり合う点」だからです)。だから、ばらつきの大きさを表したくても、偏差をそのまま足したのでは常に 0 で役に立ちません。そこで符号を消すために2乗してから足します。これが平方和(偏差平方和)で、ここでは 0.0066 mL2 です。
分散と標準偏差
平方和をデータの個数に応じた数で割ったものが分散、その平方根が標準偏差です。分析化学の教科書(Harvey)や Excel の STDEV.S は、n ではなく n−1 で割ります。
分散      s2 = Σ(xi − x)2 / (n − 1) = 0.0066 / 4 = 0.00165 mL2
標準偏差  s  = √0.00165 = 0.0406 mL  ≈ 0.041 mL
2乗したまま(分散)では単位が mL2 になり、滴定量と直接比べられません。平方根をとって元の単位(mL)に戻すのが標準偏差です。「± 0.04 mL」と滴定量の横に並べて書けるのは、単位がそろっているからです。一方で、分散には「独立なばらつきどうしは足し算できる」という便利な性質があり(Harvey §4.1)、あとで標準誤差を導くときに使います。
なぜ絶対値ではなく2乗を使うのか、という疑問もよく出ます。理由の1つは、2乗の和が平均値のところでちょうど最小になり、計算が素直にできることです(次の節の図1)。もう1つは、正規分布の幅を表す σ とそのまま対応することです。
標準偏差が表すもの:1回の測定のばらつき
測定値のばらつきが多くの小さな偶然の誤差の積み重ねで生じるとき、測定値はおおよそ正規分布に従います(Harvey §4.4。中心極限定理)。正規分布では、平均 ± 1σ の範囲に全体の約68.3%、± 2σ に約95.4%、± 3σ に約99.7% が入ります。
つまり標準偏差 0.041 mL は、「この滴定法で測った値は、真の平均 μ ± σ の範囲に約68%が入る」という σ の推定値で、1回の測定の再現性の目安です。手元の 12.47 ± 0.04 mL(x ± s)を使って「次の1回がこの範囲に入る確率」を考えると、x も s も推定値なので68%より低く、n=5 では約59%になります(t 分布で計算した値)。何回測っても、この値自体は小さくなりません。ビュレットの読み取りや終点の色の見極めといった、1回ごとの操作のばらつきで決まっているからです。分析化学ではこれを精度(precision)と呼び、標準偏差や相対標準偏差で表します。同じ人が同じ日に同じ器具で繰り返したときの精度は併行精度(repeatability)と呼ばれ、日や人を変えたときの精度と区別されます(検出限界と定量限界の記事の分析法バリデーションの節)。
なぜ n−1 で割るのか
「平均を出すときは n で割るのに、分散はなぜ n−1 なのか」は、試験でも面接でも定番の質問です。答えを一言でいうと、真の平均 μ の代わりに、同じデータから計算した平均値 x を使うと、平方和が必ず小さめに出るからです。3つの見方で確かめます。
理由1:平均値から測った平方和は小さめに出る
基準にとる値を a として、平方和 S(a)=Σ(xi − a)2 を a の関数と見てみます。展開すると a の2次関数になり、a で微分して 0 とおくと a=x のときに最小になることがわかります。つまり平方和を最も小さくする基準点が、ちょうど平均値です。さらに、次の恒等式が成り立ちます。
Σ(xi − μ)2 = Σ(xi − x)2 + n(x − μ)2

例:真の平均を仮に μ = 12.50 mL とすると
  0.0111 = 0.0066 + 5 × (12.47 − 12.50)2 = 0.0066 + 0.0045
本来知りたいのは、真の平均 μ のまわりのばらつき(左辺)です。ところが μ は知らないので、代わりに x を使うと、右辺の第2項 n(x − μ)2 のぶんだけ必ず小さくなります。x が μ とぴったり一致しない限り、この差は 0 より大きいからです。
では、平均するとどのくらい小さくなるのか。次の節で見るように平均値 x のばらつき(分散)は σ2/n なので、n(x − μ)2 の平均はちょうど n × σ2/n=σ2 です。左辺の平均は nσ2 なので、x から測った平方和の平均は nσ2 − σ2=(n−1)σ2 になります。だから n−1 で割ると、平均してちょうど σ2 になる(偏りのない推定になる)のです。Harvey の教科書も「n の代わりに n−1 を使うと s2 が σ2 の不偏推定量になる」と説明しています。
各測定値 xi が平均 μ、分散 σ2 で互いに独立だとします。期待値(何度も繰り返したときの平均)を E[ ] と書きます。
1. 左辺:E[Σ(xi − μ)2] = ΣE[(xi − μ)2] = nσ2(分散の定義そのもの)
2. 第2項:E[n(x − μ)2] = n × Var(x) = n × σ2/n = σ2(Var(x)=σ2/n は標準誤差の節で導く)
3. 恒等式から E[Σ(xi − x)2] = nσ2 − σ2 = (n − 1)σ2
したがって s2=Σ(xi − x)2/(n − 1) の期待値は σ2 に等しくなります。n で割った分散の期待値は (n − 1)/n × σ2 で、n=5 なら真の分散の8割に偏ります。
理由2:全通りを数えて確かめる
式だけでは実感がわかないので、全部の場合を数えてみます。ある滴定で、出る値が 12.4、12.5、12.6 mL の3通りだけで、どれも同じ確率で出ると仮定します(説明用の仮の設定です)。このとき真の平均は μ=12.5 mL、真の分散は σ2=(0.12 + 0 + 0.12)/3=0.00667 mL2 です。ここから2回測る(n=2)ときの、起こりうる9通りすべてで分散を計算します。
| 1回目, 2回目 | 平均 x | n で割った分散 | n−1 で割った分散 |
|---|---|---|---|
| 12.4, 12.4/12.5, 12.5/12.6, 12.6(3通り) | 12.4/12.5/12.6 | 0 | 0 |
| 12.4 と 12.5、12.5 と 12.6 の組(順序違いを含め4通り) | 12.45 または 12.55 | 0.0025 | 0.005 |
| 12.4 と 12.6 の組(2通り) | 12.5 | 0.01 | 0.02 |
| 9通りの平均 | 12.5 | 0.00333(真の値の半分) | 0.00667(真の値と一致) |
n で割った分散は、9通りを平均しても真の分散 0.00667 の半分((n−1)/n=1/2)にしかなりません。特に、2回とも同じ値が出た3通りでは「ばらつき 0」と判定してしまいます。2つの値の平均は必ず2つの値の真ん中にあるので、真ん中から測った距離は、真の平均から測った距離より小さく出やすいのです。n−1 で割ると、9通りの平均がちょうど真の分散に一致します。
理由3:自由度——偏差のうち自由に動けるのは n−1 個
偏差の合計は必ず 0 でした。したがって5つの偏差のうち4つが決まれば、残りの1つは自動的に決まります(上の表なら −0.01、+0.05、+0.02、−0.06 が決まれば、5つ目は 0.00 しかありえません)。ばらつきの情報を運んでいる独立な偏差は n−1 個しかない、というのが自由度(degrees of freedom)の考え方です。平均値を同じデータから1つ推定したので、自由度が1つ減ったと言い換えることもできます。
n で割るのはどんなときか
n−1 で割る補正が必要なのは、真の平均がわからず、同じデータの平均値で代用したときだけです。次のような場合は n で割ります。
- データが母集団そのもののとき:たとえばクラス全員の点数のように、知りたい集団を全部測ってしまった場合。推定ではなく、その集団の記述になる(Excel の STDEV.P)
- 測定値の母平均 μ そのものがわかっているとき:μ から直接測るので平均を推定に使わず、自由度は n のまま。ただしこれは理論上の話で、実務ではまず起こらない。たとえば標準物質の認証値は「測る量の真の値」であって「その測定法で測ったときの母平均」ではなく、測定法に系統誤差(かたより)があれば両者はずれる。そのとき Σ(x − 認証値)2/n の期待値は σ2 +(かたより)2 になり、ばらつきとかたよりが混ざってしまう。測定法にかたよりがないとわかっている場合を除き、実務では平均値から計算した s を使う
なお、n−1 で割ると分散は偏りがなくなりますが、その平方根の標準偏差 s は、それでもわずかに小さめに出ます。平方根は上に凸な関数なので、平均してから平方根をとった値の方が、平方根をとってから平均した値より大きくなります(Jensen の不等式)。つまり s の期待値は √(s2 の期待値)=σ を超えられず、E[s] ≤ σ になるのです。正規分布の場合、s の期待値は真の σ の 0.886 倍(n=3)、0.940 倍(n=5)、0.973 倍(n=10)です。ふつうの実験報告ではこの補正はせず、n−1 で割った s をそのまま使います。
呼び名の注意:「標本標準偏差」はどちらのことか
n−1 で割ったものと n で割ったものの呼び名は、教科書によって違います。Harvey の分析化学の教科書や Excel の説明では、n−1 で割ったものを「標本(sample)の標準偏差」としています。一方、統計学の教科書には、n で割った分散を「標本分散」、n−1 で割った分散を「不偏分散」と呼び分けるものが多くあります。試験やレポートでは、名前ではなく「n−1 で割った」と式で示すのが確実です。
Excel で計算する:STDEV.S と STDEV.P の違い
Excel には標準偏差の関数が2つあり、違いは割る数だけです。Microsoft の説明では、STDEV.S は「標本に基づいて標準偏差を推定」し n−1 法を使い、STDEV.P は「引数を母集団全体であると見なして」n 法を使います。実験の繰り返し測定は、無限に繰り返せる測定から何回かを取り出した標本なので、STDEV.S を使います。
| 求めたいもの | Excel の式(データが B2:B6) | 滴定5回の結果 |
|---|---|---|
| 平均値 | =AVERAGE(B2:B6) | 12.47 |
| 標準偏差(n−1 で割る) | =STDEV.S(B2:B6) | 0.04062 |
| n で割った標準偏差 | =STDEV.P(B2:B6) | 0.03633 |
| 標準誤差 | =STDEV.S(B2:B6)/SQRT(COUNT(B2:B6)) | 0.01817 |
| 相対標準偏差(%) | =STDEV.S(B2:B6)/AVERAGE(B2:B6)*100 | 0.326 |
| 95%信頼区間の半幅 | =CONFIDENCE.T(0.05,STDEV.S(B2:B6),COUNT(B2:B6)) | 0.0504 |
STDEV.S と STDEV.P の比は √[n/(n−1)] で、n=5 なら √(5/4)=1.118 倍、つまり約12%の違いです。n が大きくなるとこの比は1に近づき、Microsoft の説明にもあるとおり、標本数が非常に多いと2つはほぼ同じ値になります。差が問題になるのは、まさに実験でよくある3〜5回の繰り返しのときです。
関数電卓でも同じ区別があり、多くの機種で n で割るキー(σn などの表示)と n−1 で割るキー(sn−1、σn−1 などの表示)が並んでいます。表示は機種によって違うので、上の滴定データ(n−1 なら 0.0406、n なら 0.0363)を入れて、どちらのキーかを一度確かめておくと安心です。グラフに誤差棒を付ける Excel の操作は、レポートの表・グラフの書き方の誤差棒の節で説明しています([グラフ要素] の「標準偏差」ボタンは、各点の繰り返しではなく系列全体から計算される点に注意)。
標準誤差:平均値はどれだけ確かか
標準誤差の定義
標準偏差が「1回の測定値のばらつき」なら、標準誤差(standard error of the mean、平均の標準誤差)は「平均値のばらつき」です。5回の滴定をひとまとまりとして、それを何度も繰り返したと想像してください。そのたびに5回の平均値が得られ、平均値もまた少しずつばらつきます。そのばらつきの大きさが標準誤差です。
標準誤差 SE = s / √n = 0.0406 / √5 = 0.0182 mL ≈ 0.018 mL
国際的な不確かさの指針である GUM(JCGM 100:2008)では、同じ量を「平均の実験標準偏差」と呼び、繰り返し測定の平均値の標準不確かさ(タイプA評価)として使います。GUM は、これは平均値の誤差そのものではなく、偶然の効果による平均値の不確かさの尺度だと注意しています。真の誤差は誰にもわからないからです。不確かさを掛け算や割り算で組み合わせて濃度などの最終結果まで運ぶ方法は、誤差の伝播と不確かさの記事で扱います。
なぜ √n で小さくなるのか
理由は、分散が足し算できることにあります。互いに独立な測定値を n 個足すと、和の分散は各分散の和、つまり nσ2 になります。平均値は和を n で割ったものなので、分散は 1/n2 倍されます。
和の分散      Var(x1 + x2 + … + xn) = nσ2      (独立なので分散が足せる)
平均の分散    Var(x) = nσ2 / n2 = σ2 / n
平均の標準偏差  σ / √n   → σ を s で置き換えたものが SE = s / √n
直観的には、1回ごとの誤差はプラスにもマイナスにも出るので、足し合わせると一部が打ち消し合う、ということです。ただし打ち消しは完全ではなく、和の「ばらつき」は n 倍ではなく √n 倍にしか増えません。それを n で割るので、平均値のばらつきは 1/√n になります。
ここから実験計画で大事な結論が出ます。標準誤差を半分にするには、測定回数を4倍にしなければならないということです。5回を20回にしても標準誤差は 0.018 から 0.009 mL になるだけです。一方、標準偏差は何回測っても 0.04 mL 前後のままです(図2)。
繰り返しても小さくならない誤差
標準誤差が √n で小さくなるのは、測定ごとにランダムに出る偶然誤差だけです。毎回同じ向きに同じだけずれる系統誤差は、何回繰り返しても平均の中に残ります。滴定でいえば、次のようなものです。
- 標準液の濃度のずれ:NaOH 水溶液の濃度(ファクター)が表示とずれていれば、5回とも同じ割合でずれる
- ビュレットの目盛りの誤差:Harvey によると Class A の 50 mL ビュレットの許容誤差(JIS R 3505)は ±0.05 mL。同じビュレットを使い続ける限り、ずれ方は毎回同じ
- 終点の判定の癖:指示薬の色の変化を毎回少し遅れて判定すれば、滴定量はいつも多めになる
Harvey はこれを、偶然誤差は精度(precision)に、系統誤差は真度・正確さ(accuracy)に影響する、と整理しています。標準誤差が小さいことは「平均値がよく再現する」ことを示すだけで、「平均値が正しい」ことの保証にはなりません。系統誤差は、標準物質での確認や、別の方法との比較で別に調べる必要があります。
何を「1回」と数えるか:独立な繰り返し
√n の議論は、n 個の測定が互いに独立であることが前提です。たとえば HPLC で、同じバイアル(試料びん)の溶液を6回注入した面積の標準偏差は、注入と検出のばらつき(装置の繰り返し精度)だけを表します。試料をはかり取って溶かす操作のばらつきは入っていないので、これを「試料の含量の標準誤差」として使うと、確かさを過大に見積もってしまいます。Cumming らも、同じ試料を繰り返し測った値(replicate)から計算した誤差棒や統計を、独立に繰り返した実験の結果として示してはいけない、と注意しています。滴定でも、1回ごとにホールピペットで新しく分取して滴定するから、5回の値を独立な繰り返しとして扱えるのです。
標準偏差と標準誤差の使い分け
同じ5回のデータに、標準偏差・標準誤差・95%信頼区間の誤差棒を付けて並べると、図3のようになります。標準偏差の棒は標準誤差の √5=2.24 倍、95%信頼区間の棒は標準誤差の 2.776 倍(自由度4の t の値)の長さです。
どれを使うかは「何を伝えたいか」で決まります。Cumming らの整理では、範囲と標準偏差はデータのばらつきを記述する誤差棒、標準誤差と信頼区間は平均値について推測する誤差棒です。
| 伝えたいこと | 使うもの | 例 |
|---|---|---|
| 測定法・操作のばらつき(1回の測定がどれだけ再現するか) | 標準偏差、相対標準偏差 | 「この滴定は RSD 0.3% で再現した」、分析法の精度の評価 |
| 平均値がどれだけ確かか | 標準誤差 | 不確かさの計算に入れる値(GUM の標準不確かさ) |
| 真の平均 μ がありそうな範囲、2つの平均の比較 | 95%信頼区間 | 「濃度は 0.1247 ± 0.0005 mol/L(95%信頼区間)」 |
どれを選んでも、必ず守ることが2つあります。1つ目は、誤差棒が何を表すか(SD か SE か CI か)と、n を図の説明や表の注に書くことです(Cumming らの規則1・2)。書いていない誤差棒は、読み手が意味を取り違えるもとになります。2つ目は、n が3のように小さいときは誤差棒より個々の点をそのまま描く方が情報が多い、ということです。もう1つ知っておきたいのは、Cumming らが、対照群との比較のように平均どうしを比べる図では SD より標準誤差か信頼区間を示すのが通常は適切だ、としていることです(規則4)。比べたいのが平均値なら、平均値の確かさを表す誤差棒を使うべきだからです。一方、学生実験のように「自分の操作がどれだけ再現したか」を見せることが目的なら、この記事では、ばらつきそのものを伝える標準偏差を選び「平均 ± 標準偏差(n=5)」と書くことをすすめます。どちらの場合も、実験書や担当教員の指定があればそれに従います。軸の単位や凡例を含めたグラフ全体の作法は、レポートの表・グラフの書き方にまとめています。
標準誤差の棒を見て「棒が重ならないから有意差あり」と判断するのは危険です。平均 ± 1SE の範囲は、n が十分大きくても真の平均を含む確率は約68%しかなく、n が小さいとさらに下がります。Cumming らは、95%信頼区間のおよその長さは n が10以上なら SE の約2倍、n=3 なら約4倍だとしています。この「約4倍」は、次の節の t の値(自由度2で4.303)から来ています。2つの平均の差をきちんと判定するには t 検定を使います。
報告するときの桁
GUM は、標準不確かさは多くとも有効数字2桁で示せば足り、推定値はその桁にそろえて丸める、としています。標準偏差は5回程度の測定からでは自分自身がかなりあいまいなので(次の節)、3桁も4桁も書く意味はありません。滴定の例なら「12.470 ± 0.041 mL」または「12.47 ± 0.04 mL(平均 ± 標準偏差、n=5)」のように、平均の最後の桁を標準偏差の桁にそろえます。途中の計算では桁を落とさず、最後に丸めます(有効数字の記事)。
平均値の95%信頼区間(t 分布)
式と t の値
平均値のまわりに標準誤差の何倍かの幅をとり、「真の平均 μ がありそうな範囲」を示したものが信頼区間です(Harvey §4.4)。
μ = x ± t × s / √n      (t は自由度 n − 1 の t 分布の値)

滴定5回: 12.470 ± 2.776 × 0.0182 = 12.470 ± 0.050 mL  (12.420〜12.520 mL)
| 測定回数 n | 自由度 n−1 | 95%両側の t |
|---|---|---|
| 2 | 1 | 12.706 |
| 3 | 2 | 4.303 |
| 4 | 3 | 3.182 |
| 5 | 4 | 2.776 |
| 10 | 9 | 2.262 |
| 20 | 19 | 2.093 |
| ∞(σ が既知) | ∞ | 1.960(正規分布の z) |
Excel では t の値を =T.INV.2T(0.05, 自由度) で求められます(n=5 なら =T.INV.2T(0.05,4) で 2.776)。半幅を一度に出すなら =CONFIDENCE.T(0.05, 標準偏差, 標本数) です。Microsoft の使用例 CONFIDENCE.T(0.05,1,50)=0.284 は t(自由度49)÷ √50 と一致するので、この関数が返すのは区間の全幅ではなく半幅(± の後ろの数字)です。
なぜ 1.96 ではなく t を使うのか
真の σ がわかっていれば、95%の範囲は正規分布から ± 1.96σ/√n です。ところが実際には σ の代わりに、5回程度の測定から計算した s を使っています。この s 自体があいまいなのです。GUM は、正規分布のとき s の相対的なあいまいさ(s 自身の相対標準偏差)が約 1/√[2(n−1)] になるとしています(n=10 で24%)。この式で計算すると、n=3 なら約50%、n=5 でも約35% です。たまたま s が小さく出たときにも区間が真の平均 μ を取りこぼさないように、n が小さいほど幅を広げて補うのが t 分布の役割です。n が大きくなって s が信用できるようになると、t は 1.96 に近づきます。
このため、測定回数を減らすと信頼区間は急に広がります。滴定の最初の3回(12.46、12.52、12.49 mL)だけで計算すると、s=0.030 mL と5回のときより小さいのに、95%信頼区間の半幅は 4.303 × 0.030/√3=0.075 mL と、5回のとき(0.050 mL)より広くなります。
「95%」の意味
「95%信頼区間」は、「真の平均 μ がこの区間に入っている確率が95%」と読まれがちですが、正確には同じ手順で区間を作ることを何度も繰り返すと、そのうち約95%の区間が μ を含むという意味です(Cumming らの説明「95% CIs capture μ on 95% of occasions」)。μ は動かず、実験のたびに動くのは区間の方です。ある1回の区間が μ を含んでいるかどうかは、私たちにはわかりません。なお、ここでの μ は「この測定法で無限に測ったときの平均」で、系統誤差がなければ真の値に一致します。系統誤差があれば、信頼区間をいくら狭くしても真の値からずれたままです。
相対標準偏差(RSD)と変動係数(CV)
定義:同じ量の2つの名前
相対標準偏差(relative standard deviation、RSD)は標準偏差を平均値で割った値で、100 を掛けて % で表すことが多い量です。変動係数(coefficient of variation、CV)も同じ定義の量で、分析化学の教科書(Harvey)は相対標準偏差と呼び、統計学では変動係数と呼ぶことが多い、という呼び名の違いにすぎません(英語でも coefficient of variation は relative standard deviation とも呼ばれます)。
RSD(%) = CV(%) = s / x × 100

滴定5回: 0.0406 / 12.47 × 100 = 0.33 %
なぜ平均で割るのか:単位も大きさも違うものを比べる
標準偏差は単位をもち、測る量の大きさにつれて大きくなりがちです。0.041 mL のばらつきは、12 mL の滴定では小さいですが、0.5 mL の滴定なら大きすぎます。平均で割ると単位が消え、「値の何%ぶれるか」という共通のものさしになります。たとえば、滴定量の RSD が 0.33%、HPLC で同じ溶液を6回注入したピーク面積(平均 152228、標準偏差 448)の RSD が 0.29% なら、単位も桁もまったく違う2つの測定の精度を、そのまま比べられます。
RSD には、定数倍しても変わらないという便利な性質もあります。滴定量から塩酸の濃度を c=0.1000 mol/L × V ÷ 10.00 mL で計算すると、平均は 0.12470 mol/L、標準偏差は 0.00041 mol/L に変わりますが、RSD は 0.33% のままです。平均も標準偏差も同じ係数(0.01)倍されるので、比は変わらないからです。足し算や別の測定値との掛け算が入る場合の扱いは、誤差の伝播の話になります。
RSD・CV を使ってはいけない場面
- 平均が 0 に近いとき:分母が小さいので RSD は極端に大きくなり、意味をなさない。ブランクの値や、検出限界付近の小さな信号がこれに当たる。検出限界と定量限界の考え方では、ばらつき σ が一定なら、定量限界(10σ)の量で RSD がちょうど10%になる。逆にいえば、それより少ない量では RSD が急に悪化する
- 0 が「何もない」を意味しない尺度:温度の °C が典型。0、10、20、30、40 °C の5つの値は、標準偏差 15.8 °C、CV 79% になるが、同じ温度をケルビンで書くと標準偏差は同じ 15.8 K なのに CV は 5.39%、華氏なら 42% になる。0 の位置を人が決めた尺度では、平均で割る意味がない
- 正負の両方をとる量:差や変化量(たとえば ΔH)は平均が 0 をまたぎうるので、RSD は使わず標準偏差のまま示す
計算例(数値は計算練習用の仮の値)
ここからの例題の数値はすべて練習用に作った仮の値で、答えは Python で計算して確かめてあります。
例題1:ファクターの平均・標準偏差・RSD・信頼区間
0.1 mol/L 水酸化ナトリウム水溶液をフタル酸水素カリウムで4回標定し、ファクター f として 1.012、1.008、1.015、1.009 を得た。平均、標準偏差、相対標準偏差、標準誤差、95%信頼区間を求めよ。
平均 f=(1.012 + 1.008 + 1.015 + 1.009)/4=1.011
偏差は +0.001、−0.003、+0.004、−0.002 で、平方和=(1 + 9 + 16 + 4) × 10−6=30 × 10−6
標準偏差 s=√(30 × 10−6 / 3)=√(1.0 × 10⁻⁵)=0.0032(0.003162)
相対標準偏差=0.003162 / 1.011 × 100=0.31%
標準誤差=0.003162 / √4=0.0016
95%信頼区間:t(自由度3)=3.182 なので、1.011 ± 3.182 × 0.001581=1.011 ± 0.005(1.006〜1.016)
参考:n で割った標準偏差(STDEV.P)は 0.0027 で、n=4 では約13%小さく出る。
例題2:STDEV.S と STDEV.P のどちらを使うか
次の(1)(2)で、Excel の STDEV.S と STDEV.P のどちらを使うのが適切か。(1)上の滴定5回の滴定量から、この滴定操作の精度を報告する。(2)ある研究室に今ある20本のビュレットについて、全数の目盛りの補正値を測り、「この20本の補正値のばらつき」を記述する。
(1)STDEV.S。5回の滴定は、いくらでも繰り返せる滴定から取り出した標本で、真の平均がわからないので平均値で代用している。n−1 で割らないと、ばらつきを小さく見積もる。
(2)STDEV.P。知りたい集団(この20本)を全部測っているので、推定ではなく記述になる。ただし「同じメーカーのビュレット一般の補正値のばらつき」を推定したいのなら、20本はその標本なので STDEV.S を使う。どちらを使うかは、データそのものではなく「何について述べたいか」で決まる。
例題3:何回測ればよいか
ある滴定の1回ごとの標準偏差が s=0.040 mL とわかっている。(1)平均値の標準誤差を 0.010 mL 以下にするには何回測ればよいか。(2)95%信頼区間の半幅を 0.020 mL 以下にするには何回測ればよいか(s は変わらないものとする)。
(1)0.040 / √n ≤ 0.010 より √n ≥ 4、n ≥ 16 回。5回のときの標準誤差 0.018 mL を半分強にするのに3倍以上の回数が要る。
(2)t × 0.040 / √n ≤ 0.020 を満たす最小の n を、t が n とともに変わることに注意して探す。n=16 では t=2.131 で半幅 0.0213 mL(不足)、n=17 では 0.0206 mL(不足)、n=18 では t=2.110 で 0.0199 mL。n=18 回。標準誤差だけで考えた(1)の16回より多くなるのは、t が 2 より大きいから。
例題4:分取量が違う2人の精度を比べる
同じ塩酸を、Aさんは 10.00 mL ずつ分取して5回滴定し、滴定量は本文の 12.46、12.52、12.49、12.41、12.47 mL だった。Bさんは 20.00 mL ずつ分取して5回滴定し、24.91、24.98、24.95、25.02、24.89 mL だった。どちらの精度がよいといえるか。また、この5回ずつのデータからそう断定できるか。
A:平均 12.47 mL、標準偏差 0.041 mL、RSD 0.33%
B:平均 24.95 mL、偏差は −0.04、+0.03、0.00、+0.07、−0.06、平方和 0.0110、標準偏差 √(0.0110/4)=0.052 mL、RSD=0.052/24.95 × 100=0.21%
標準偏差だけを見ると B の方が大きいが、B は2倍の量を滴定しているので滴定量そのものが2倍ある。濃度の結果に効くのは滴定量に対するばらつきの割合なので、比べるのは RSD で、RSD が小さいのは B(0.21% 対 0.33%)。
ただし、この5回ずつのデータだけでは「B の方が精度がよい」とは断定できない。5回から求めた s は、それ自体が約35%ゆらぐ(GUM の近似式)。濃度に換算した分散の比(RSD の比の2乗)は F=(0.3257/0.2102)2=2.40 で、自由度 (4, 4) の F 分布の両側5%の臨界値 9.60 よりずっと小さく、p は約0.42。偶然でもこの程度の差は普通に出る。はっきりさせるには、F 検定で判定するか、回数を増やす。
それでも B が有利だと考える根拠はある。ビュレットの読み取りの誤差(0.01 mL 単位の読みで ±0.01〜0.03 mL 程度)は滴定量によらずほぼ一定なので、滴定量を大きくとるほど、滴定量に対する割合としての誤差は小さくなるからだ。
よくある間違い
なかでも最初の間違いは、レポートでも論文でもよく見かけます。標準誤差は n を増やすほど小さくなるので、「ばらつきが小さく、きれいなデータに見える」誤差棒になります。しかし、読み手が知りたいのが「この方法で1回測るとどれくらいぶれるか」なら、答えは標準偏差の方です。どちらを使うかは見た目で選ぶのではなく、伝えたいことで選び、その種類と n を必ず書きます。
試験での問われ方
大学の分析化学・物理化学実験、院試では、次のような形で出題されます。
- 計算:数個の測定値から平均・標準偏差・相対標準偏差を求める(例題1)。n−1 で割ることと、有効数字の扱いが採点の対象になりやすい
- 説明:「標準偏差と標準誤差の違いを述べよ」「なぜ n−1 で割るのか」。平方和が平均値で最小になること、または自由度で説明できればよい
- 信頼区間:t 分布表を与えて95%信頼区間を求める。自由度を n−1 にすることと、t が n で変わることを忘れない(例題3)
- 精度と真度:偶然誤差と系統誤差の違い、繰り返し測定で減らせるのはどちらか
- 検量線との接続:検量線の傾き・切片の標準誤差(最小二乗法)や、検出限界の 3.3σ/S の σ が何の標準偏差か(検出限界と定量限界)
まとめ
標準偏差と標準誤差の違いは、「1回の測定の話か、平均値の話か」の一点に尽きます。n−1 も √n も t も、すべて「真の平均も真のばらつきも知らないまま、手元の数回の測定からそれを推し量っている」ことから出てくる補正です。この出発点さえ押さえておけば、レポートの ± の後ろに何を書くべきかで迷うことはなくなります。
よくある質問
標準偏差は、1回1回の測定値が平均のまわりにどれだけばらつくかを表し、測定回数を増やしても小さくなりません。標準誤差は、平均値そのものがどれだけ確かかを表し、標準偏差を測定回数の平方根で割った値(s/√n)です。たとえば滴定5回で標準偏差が 0.041 mL なら、標準誤差は 0.041/√5=0.018 mL になります。
真の平均の代わりに、同じデータから計算した平均値を使うと、偏差の2乗の和(平方和)が必ず小さめに出るからです。平方和は平均値のところで最小になるため、真の平均から測った場合より小さくなり、その期待値は (n−1)σ2 になります。n−1 で割ると分散の推定が平均してちょうど σ2 になります。偏差の合計は必ず 0 なので、自由に動ける偏差が n−1 個しかない(自由度が n−1)と説明することもできます。
STDEV.S は n−1 で割る標本の標準偏差、STDEV.P は n で割る母集団の標準偏差です。実験の繰り返し測定は、いくらでも繰り返せる測定から取り出した標本なので STDEV.S を使います。STDEV.P を使うのは、知りたい集団を全部測ったときだけです。n が小さいほど差は大きく、n=5 では STDEV.S が STDEV.P の約1.12倍になります。
伝えたいことで決めます。測定のばらつきそのもの(1回測るとどれだけぶれるか)を示したいなら標準偏差、平均値の確かさや2つの平均の比較を示したいなら標準誤差か95%信頼区間を使います。どれを使う場合も、誤差棒が何を表すかと測定回数 n を図の説明に必ず書きます。n が3程度と小さいときは、誤差棒より個々の測定値を点で示す方が情報が多くなります。
同じものです。どちらも標準偏差を平均値で割った値で、100 を掛けて % で表すことが多く、分析化学では相対標準偏差(RSD)、統計学では変動係数(CV)と呼ぶことが多いという、呼び名の違いです。単位や大きさの違う測定の精度を比べるのに便利ですが、平均が 0 に近い量や、摂氏温度のように 0 の位置を人が決めた尺度には使えません。
参考文献
- D. Harvey, Analytical Chemistry 2.1, Chapter 4 Evaluating Analytical Data(§4.1 Characterizing Measurements and Results、§4.2 Characterizing Experimental Errors、§4.4 The Distribution of Measurements and Results), LibreTexts
- JCGM 100:2008, Evaluation of measurement data — Guide to the expression of uncertainty in measurement(GUM), §3.2.2, §4.2.2–4.2.3, §4.3.2, §7.2.6, BIPM
- G. Cumming, F. Fidler, D. L. Vaux, “Error bars in experimental biology”, J. Cell Biol. 2007, 177, 7–11
- Microsoft サポート「STDEV.S 関数」「STDEV.P 関数」「STDEV 関数」「T.INV.2T 関数」「CONFIDENCE.T 関数」「STEYX 関数」
- Wikipedia(英語版)“Bessel’s correction”, “Unbiased estimation of standard deviation”, “Coefficient of variation”
関連記事
実験データの処理は、有効数字 → 標準偏差と標準誤差(この記事)→ 誤差の伝播 → t 検定、検量線なら 最小二乗法 の順に読むとつながります。レポートへのまとめ方は実験レポートの書き方へ。
- レポートの表・グラフの書き方|表題の位置・軸の単位・有効数字・誤差棒
- 検出限界と定量限界の違いと求め方|S/N比・3.3σ/S・分析法バリデーション
- 検量線とは?絶対検量線法・内部標準法・標準添加法の違いと使い分け
- Excel(エクセル)の近似曲線|6種類の選び方・数式とR2乗値・検量線の例
- ランベルト・ベールの法則とは?吸光度・透過率・モル吸光係数の求め方
- HPLCとは?原理・順相と逆相の違い・保持時間とクロマトグラムの読み方