t検定のやり方とp値の意味|対応のある・ないの使い分けとExcelのT.TEST
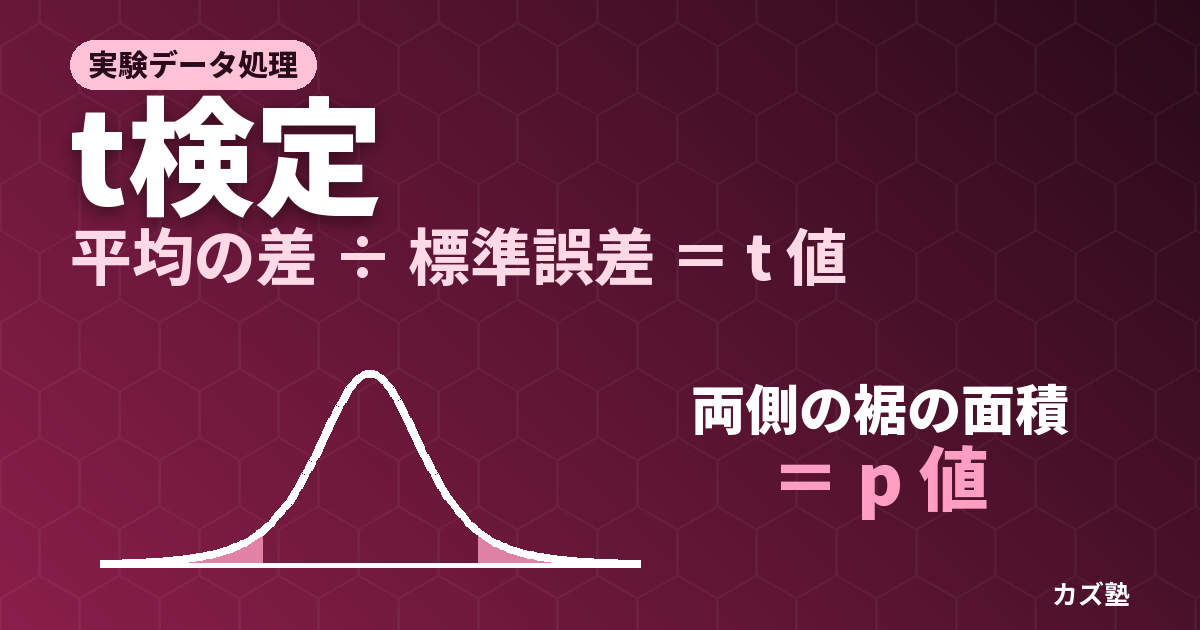
同じ塩酸を2人で滴定したら、平均の濃度が 101.1 mmol/L と 102.1 mmol/L になりました。この 1.0 mmol/L の違いは、2人のやり方に本当に差があるからでしょうか。それとも、測定のたびに出るばらつきが、たまたま平均にも出ただけでしょうか。平均を2つ並べて眺めているだけでは、どちらとも決められません。決め手になるのは、差の大きさを「平均がどれだけ揺れうるか」と比べることです。その比が t 値で、t 値を使って判定する手順が t 検定です。
計算そのものは Excel の関数1つで終わります。それでも試験やレポートで間違えるのは、「どの t 検定を選ぶのか」「p 値は何の確率なのか」「有意差が無いとき何が言えるのか」を説明できないときです。この記事では、t 値の式がなぜその形なのかから始めて、3種類の t 検定を同じ実験データの例題で計算し、Excel の T.TEST の引数の意味と、p 値の正しい読み方までをつなげます。標準偏差と標準誤差の違いそのものは標準偏差と標準誤差の記事で扱っているので、ここでは「平均を比べる」ことに集中します。
t 検定とは:平均の差を「平均の揺れ」で割る
同じ試料を何回か測ると、値は毎回少しずつ違います。だから、その平均値も、実験をやり直すたびに少しずつ違う値になります。2つの平均を比べるときに知りたいのは、「見えている差が、この平均の揺れに比べて大きいか」です。平均の揺れの目安が標準誤差で、データ数を n、測定値の標準偏差を s とすると s/√n で表されます。
いちばん単純な、平均値を1つの基準値と比べる場合で式を書くと、次のようになります。
t = (m − μ0) / (s / √n)

m:測定値の平均値   μ0:比べる基準値(認証値・理論値など)
s:測定値の標準偏差(n − 1 で割ったもの)   n:データ数
分子は「見えている差」、分母は「偶然だけでどれくらいの差が出うるかの目安」です。t は、差が平均の揺れの何倍あるかを表す数で、単位を持ちません。|t| が 1 程度なら、その差は平均の揺れの範囲に収まっていて、偶然で十分説明できます。|t| が大きいほど、偶然だけでは説明しにくくなります。
分母が s ではなく s/√n になっているのは、n 回の測定を平均すると、ランダムな誤差が互いに打ち消し合って、平均の揺れは1回の測定の揺れより小さくなるからです。揺れの大きさ(標準偏差)は √n 分の1に縮みます(理由は標準偏差と標準誤差の記事)。同じ差でも、データを増やすほど t は大きくなります。この性質が、あとで「p 値は効果の大きさを表さない」という話につながります。
なぜ正規分布ではなく t 分布なのか
もし測定のばらつきの本当の大きさ σ がわかっていれば、分母に σ/√n を使った値は標準正規分布に従い、両側 5% の境目は ±1.960 です。ところが実験では σ はわからず、同じ少数のデータから計算した s で代用します。データが少ないと、s はたまたま小さめに出ることがあり、そのときは分母が小さくなって t が大きく振れます。この「s を推定したことによる余分な揺れ」まで含めた t の分布が t 分布です。ギネスの醸造所に勤めていた W. S. Gosset が、Student という筆名で1908年に Biometrika に発表したことから、スチューデントの t 分布と呼ばれます。
t 分布は正規分布より裾が重く、その重さは自由度で決まります。自由度が小さい(データが少ない)ほど裾が重く、「ここより外なら偶然では起こりにくい」という境目(臨界値)が外側に動きます。
図1の右の表のとおり、両側 5% の臨界値は、自由度 2 で 4.303、自由度 4 で 2.776、自由度 10 で 2.228 と、データが増えるにつれて 1.960 に近づきます。3回測定(自由度 2)のデータに正規分布の 1.96 を当てはめると、帰無仮説が正しくても |t| が 1.96 を超える確率は 18.9% あり、「5% で判定したつもり」が実際には約4倍の頻度で誤ります。少数のデータで t 分布を使うのは、この過信を防ぐためです。
| 自由度 | 両側 5% | 両側 1% | 片側 5% |
|---|---|---|---|
| 2 | 4.303 | 9.925 | 2.920 |
| 3 | 3.182 | 5.841 | 2.353 |
| 4 | 2.776 | 4.604 | 2.132 |
| 5 | 2.571 | 4.032 | 2.015 |
| 10 | 2.228 | 3.169 | 1.812 |
| 30 | 2.042 | 2.750 | 1.697 |
| ∞(正規分布) | 1.960 | 2.576 | 1.645 |
片側 5% の臨界値が両側 10% の臨界値と同じになることにも注目してください(自由度 ∞ の 1.645 は、検出限界の記事で判定限界 1.64σ として出てくる値です)。片側と両側の違いは、後の節で扱います。
自由度:なぜ n − 1 なのか
標準偏差 s は、各測定値と平均値との差(偏差)から計算します。偏差は合計すると必ず 0 になるので、n 個のうち n − 1 個が決まれば、最後の1個は自動的に決まります。ばらつきの情報を自由に持っているのは n − 1 個ぶんだけ、というのが自由度 n − 1 の意味です(標準偏差を n − 1 で割る理由と同じ話で、詳しくは標準偏差と標準誤差の記事)。データから平均を1つ決めるごとに自由度が1つ減る、と覚えておくと、2つの平均を使う Student の t 検定で自由度が nA + nB − 2 になることも、検量線の残差の自由度が「点の数 − 2」(傾きと切片の2つを決めるため)になることも、同じ理屈で説明できます。
検定の手順:仮説から結論までの5段階
どの t 検定でも、手順は同じです。
- 仮説を立てる:「母平均どうしに差はない」(帰無仮説 H0)と、「差がある」(対立仮説 H1)を書く。検定は、帰無仮説が正しいと仮定したら手元のデータがどれだけ起こりにくいかを調べる、という形で進む
- 有意水準 α と、両側か片側かを決める:化学の実験では α = 0.05 がよく使われる。データを見る前に決める
- t 値と自由度を計算する:検定の種類ごとの式で計算する(次の節)
- p 値を求めるか、臨界値と比べる:p 値 ≤ α、または |t| ≥ 臨界値なら帰無仮説を棄却する
- 結論を書く:棄却したら「有意な差がある(p = 0.012)」、棄却できなければ「有意な差があるとはいえない(p = 0.14)」。p 値そのものと、差の大きさ(できれば信頼区間)も一緒に書く
手順4の「p 値で判定する」と「臨界値と比べる」は同じことを別の側から見ているだけです。|t| が臨界値より大きいことと、|t| より外側の面積(p 値)が α より小さいことは、必ず一致します。手計算と数表なら臨界値、Excel やソフトなら p 値を使うのが便利です。
両側検定と片側検定
両側検定は、差の向きを問わず「どちらかに差があるか」を調べます。片側検定は「新しい方法のほうが大きい」のように、差の向きをあらかじめ1つに決め、逆向きの差には意味がないと言えるときにだけ使います。Harvey の教科書は、標準物質を測った結果が基準値より大きくなる(または小さくなる)と考える理由が無ければ、両側検定が適切だとしています。
同じ t 値なら、差が対立仮説で想定した向きに出たときに限り、片側の p 値は両側の半分になります(逆向きに出たときの片側の p 値は 0.5 より大きくなります)。そのため、両側で p = 0.08 だったのを見てから片側に切り替えて p = 0.04 にするのは、実質的に有意水準を 10% に緩めたのと同じです。向きの判断は、実験の目的からデータを見る前に決めておきます。
第一種の誤りと第二種の誤り
検定の判定には2種類の誤りがあります。帰無仮説が正しいのに棄却してしまう第一種の誤り(本当は差が無いのに「差がある」と言う)と、帰無仮説が誤りなのに棄却できない第二種の誤り(本当は差があるのに見逃す)です。有意水準 α は、第一種の誤りの確率をこの値に抑える、という約束です。
α を小さくすれば第一種の誤りは減りますが、そのぶん差を見逃しやすくなります。データが少ないときや、ばらつきが大きいときも見逃しは増えます。だから、「有意な差があるとはいえない」は「差が無い」という意味ではありません。単に、このデータの量とばらつきでは差を見分けられなかった、ということです。
3種類の t 検定と選び方
t 検定は、何と何を比べるか、データがどう組になっているかで3種類(対応のない場合はさらに2通り)に分かれます。
| 種類 | 比べるもの・化学の例 | 自由度 | Excel |
|---|---|---|---|
| 1標本の t 検定 | 平均値と基準値。認証値のある標準物質や、正確に調製した標準液を測って、方法にかたより(系統誤差)が無いかを見る | n − 1 | T.TEST には1標本の形式が無い。t を式で出して T.DIST.2T(基準値を並べた列と対応ありで比べてもよい) |
| 対応のある t 検定 | 同じ試料を2つの条件で測った値の差。同じ試料を2つの分析法で測る、同じ試料の処理前と処理後を測る | 組の数 − 1 | T.TEST(検定の種類 1) |
| 対応のない t 検定(Student) | 独立な2群の平均。2人の実験者、2つのロット。2群の分散が等しいと仮定する | nA + nB − 2 | T.TEST(検定の種類 2) |
| 対応のない t 検定(Welch) | 同上。分散が等しいと仮定しない | Welch–Satterthwaite の式(整数にならない) | T.TEST(検定の種類 3) |
選ぶ順番は、まず対応があるかどうかです。これはデータの数値を見て決めるのではなく、実験をどう組んだかで決まります。1つ目のデータと2つ目のデータが「同じ試料」「同じ日の同じ溶液」のように1対1で結びついていれば対応あり、別々に用意した試料なら対応なしです。対応がなければ、次の節で見る理由から、Welch の t 検定を基本にします。
1標本の t 検定:測定値は基準値とずれているか(例題1)
例題1:濃度 10.00 mg/L に正確に調製した標準液を、ある方法で5回測定し、次の値を得た(数値は計算練習用の仮の値)。この方法の測定値は、調製値からずれているといえるか。有意水準 5%、両側で判定せよ。
測定値(mg/L):10.08, 10.12, 10.03, 10.15, 10.07
平均値 m = 10.090 mg/L、標準偏差 s = 0.0464 mg/L(偏差 −0.01, 0.03, −0.06, 0.06, −0.02 の2乗和 0.0086 を 4 で割って平方根)、標準誤差 s/√5 = 0.02074 mg/L。t = (10.090 − 10.00) / 0.02074 = 4.34、自由度 4(t と信頼区間は丸める前の値で計算)。両側 5% の臨界値 2.776 より大きいので、帰無仮説(かたよりは無い)を棄却する。p = 0.012。平均の 95% 信頼区間は 10.090 ± 2.776 × 0.02074 = 10.03〜10.15 mg/L で、調製値 10.00 を含まない。
この結果が示しているのは、「この方法は、ばらつきだけでは説明できない程度に高めに出る」ということです。差は 0.09 mg/L(0.9%)で、これが実用上問題になる大きさかどうかは、統計ではなく化学の判断です。高めに出る原因(ブランクの引き方、検量線の切片、標準液の調製など)を探すのは、検量線の記事やランベルト・ベールの法則の記事で扱った、測定の側の話になります。
同じ考え方は、文献値・理論値との比較にも使えます。ただし、比べる基準値そのものに不確かさがあるとき(文献の融点など)は、その不確かさも考える必要があり、1標本の t 検定だけで「ずれている」と言い切ることはできません。
対応のある t 検定:同じ試料を2つの方法で測ったとき(例題2)
例題2:濃度の異なる6つの試料を、方法 A と方法 B の両方で測定した(仮の値)。2つの方法の結果に差があるといえるか。有意水準 5%、両側で判定せよ。
| 試料 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 方法 A | 2.15 | 5.48 | 8.92 | 12.36 | 15.70 | 20.11 |
| 方法 B | 2.08 | 5.37 | 8.85 | 12.21 | 15.63 | 19.98 |
| 差 d = A − B | 0.07 | 0.11 | 0.07 | 0.15 | 0.07 | 0.13 |
対応のある t 検定では、組ごとの差 d を1列のデータとみなし、「差の母平均は 0」という帰無仮説で1標本の t 検定をします。
t = md / (sd / √n)      自由度 = n − 1(n は組の数)

md = 0.100   sd = 0.0352   sd / √6 = 0.01438
t = 0.100 / 0.01438 = 6.96   自由度 5   両側 5% の臨界値 2.571
(t と信頼区間は丸める前の値 sd / √6 = 0.014376 で計算)
p = 0.00094   差の 95% 信頼区間 0.063〜0.137
|t| = 6.96 は臨界値 2.571 を大きく超え、方法 A は方法 B より平均 0.10 高く出る、と結論できます。
同じデータを対応なしで検定すると、差は見えなくなる
このデータを、うっかり2つの独立な群として対応のない t 検定にかけると、p = 0.98 になり、差はまったく検出できません(図3の左)。方法 A の6つの値の標準偏差は 6.63 もあり、これは方法の違いではなく、試料ごとの濃度の違いから来るばらつきです。対応なしの検定では、この大きなばらつきが分母に入り、0.10 という方法の差を埋もれさせてしまいます。
組ごとに差をとると、試料ごとの濃度の違いは A と B に同じだけ入っているので引き算で消え、方法の違いだけが残ります(図3の右)。Harvey の教科書も、対応のあるデータは、母集団の中の大きなばらつきが平均の t 検定に悪影響を与えるのを防ぐ、と説明しています。同じ試料を両方の方法で測れる実験なら、対応のある設計にしたほうが、少ないデータで差を見つけやすいのです。
ただし、この例のように濃度の範囲が広いときは、差が濃度によらず一定とは限りません(濃度に比例して大きくなる「比例誤差」なら、差の平均だけでは方法の関係を表しきれません)。Harvey は、広い濃度範囲の対応データでは、片方の方法の結果をもう一方に対してプロットする回帰のほうが適切だとしています。回帰直線の傾きと切片の求め方は最小二乗法の記事で扱います。
対応のない t 検定:Student と Welch(例題3)
例題3:同じ塩酸を、実験者 X と実験者 Y がそれぞれ別々に NaOH 標準液で滴定し、濃度を求めた(仮の値。単位 mmol/L)。2人の結果に差があるといえるか。有意水準 5%、両側で判定せよ。
X(8回):101.2, 100.9, 101.1, 101.0, 101.3, 101.1, 101.0, 101.2
           平均 101.10   標準偏差 0.131
Y(4回):102.8, 101.2, 103.1, 101.3
           平均 102.10   標準偏差 0.990

差 = 102.10 − 101.10 = 1.00 mmol/L
X は回数が多くばらつきが小さく、Y は回数が少なくばらつきが大きい、という組み合わせです。分散(標準偏差の2乗)の比は 0.980 / 0.0171 ≈ 57 倍あります。
Student の t 検定(等分散を仮定)
2群の母分散が等しいと仮定し、2群の分散を自由度で重みをつけて平均した合算分散を、両方の群に共通の分散として使います。
sp2 = [(nX − 1)sX2 + (nY − 1)sY2] / (nX + nY − 2)
t = (mY − mX) / [sp √(1/nX + 1/nY)]      自由度 = nX + nY − 2

sp2 = (7 × 0.0171 + 3 × 0.980) / 10 = 0.306    sp = 0.553
t = 1.00 / (0.553 × √(1/8 + 1/4)) = 1.00 / 0.339 = 2.95
自由度 10   両側 5% の臨界値 2.228   p = 0.014
Student の t 検定では「有意な差がある」という結論になります。
Welch の t 検定(等分散を仮定しない)
分散を合算せず、それぞれの群の分散をそのまま使います。そのかわり、t の分布は t 分布にぴったりは従わないので、近い t 分布の自由度を Welch–Satterthwaite の式で求めます(Satterthwaite が1946年に分散成分の推定について示した近似と、Welch が1947年に Biometrika に発表した2群の比較の扱いにちなむ名前)。
t = (mY − mX) / √(sX2/nX + sY2/nY)

自由度 ν = (sX2/nX + sY2/nY)2 / [ (sX2/nX)2/(nX − 1) + (sY2/nY)2/(nY − 1) ]

sX2/nX = 0.0171 / 8 = 0.00214    sY2/nY = 0.980 / 4 = 0.245
t = 1.00 / √(0.00214 + 0.245) = 1.00 / 0.497 = 2.01
ν = 3.05   両側 5% の臨界値 3.15   p = 0.136
同じデータなのに、Welch の t 検定では「有意な差があるとはいえない」になりました。t が 2.95 から 2.01 に小さくなり、自由度も 10 から約3に減って臨界値が 2.23 から 3.15 に上がったためです(図2)。
なぜ結果が分かれるのか
t の分母に入る「平均の差の揺れ」は、2つの平均それぞれの揺れ(分散 ÷ データ数)の和です。Y の平均の揺れは、本来 Y 自身の分散から 0.980 / 4 = 0.245 と見積もるべきものです。ところが Student の t 検定では、合算分散 0.306 を Y にも当てはめるので、Y の平均の揺れを 0.306 / 4 = 0.0765 と、実際の3分の1以下に見積もってしまいます。合算分散は、回数が多くばらつきの小さい X に引っ張られて小さくなっているからです。その結果、分母が小さくなって t が過大になります。
このように、データ数の少ない群のほうがばらつきが大きいとき、Student の t 検定は差を過大に評価しやすいのです(逆に、データ数の多い群のほうがばらつきが大きいときは、差を見逃しやすくなります)。Welch の自由度が約3と小さいのも筋が通っています。差の揺れのほとんどを、たった4回の測定しかない Y の分散が決めているので、その分散の推定の確かさ(自由度 3 ぶん)しか持っていないからです。
どちらを使うか:Welch を基本にする
分散が等しいかどうかわからないときは、Welch の t 検定を基本にすることが勧められています。Ruxton(2006)や Delacre ら(2017)は、Student の t 検定の代わりに Welch の t 検定を標準に使うよう提案しており、統計ソフト GraphPad Prism の手引きも、等分散を仮定する Student の t 検定を使うはっきりした理由が無い限り Welch を既定にすることを勧めています。分散が本当に等しい場合でも、Welch で失うものはわずかだからです。
「先に F 検定(Excel の F.TEST)で分散が等しいか調べて、等しければ Student、違えば Welch」という二段階のやり方は、一見合理的に見えます。しかし GraphPad の手引きは、これをよい計画ではないとしています。小さなデータでは F 検定が分散の違いを見逃しやすく、検定を重ねることで判定の性質も変わるからです。どちらの t 検定を使うかは、データを見てからではなく、実験を計画する段階で決めておきます。
Welch の t 検定で t = 2.01、自由度 3.05、p = 0.14 となり、有意水準 5% で有意な差があるとはいえない。平均の差 1.00 mmol/L の 95% 信頼区間は −0.57〜2.57 mmol/L と広く、差が 0 である可能性も、2 mmol/L を超える差がある可能性も、このデータでは区別できない。Y の測定回数を増やすか、Y の滴定でばらつきが大きくなった原因(終点の判断、ビュレットの読み取りなど)を調べるべきである。
この結論の書き方が大事です。「差は無かった」と書くのは誤りです。信頼区間を見れば、データが「差が無い」ことを示しているのではなく、「差の大きさを決めるには情報が足りない」ことを示しているのがわかります。
Excel で t 検定をする:T.TEST 関数の引数
Excel では、対応のある t 検定と対応のない t 検定(Student・Welch)の p 値を、T.TEST 関数1つで求められます。
=T.TEST(配列1, 配列2, 尾部, 検定の種類)
| 引数 | 指定する値 | 意味 |
|---|---|---|
| 配列1・配列2 | 2つのデータのセル範囲 | どちらを先に書いても結果は同じ(t の符号は使わない) |
| 尾部 | 1 または 2 | 1=片側、2=両側。両側の値は片側の値の2倍。1・2以外は #NUM! |
| 検定の種類 | 1、2、3 | 1=対をなすデータ(対応のある t 検定)、2=等分散の2標本(Student)、3=非等分散の2標本(Welch) |
Microsoft の説明によると、T.TEST は2つのデータから負でない t 値を計算し、尾部が 1 なら「2つの母平均が等しいとしたとき、それより大きい t 値が出る確率」を、尾部が 2 ならその2倍を返します。t を負でない値にしてから確率を出すので、尾部 1 の値は差がどちら向きでも小さいほうの裾の確率になります(例題3で配列1と配列2を入れ替えても 0.0681 のまま)。片側検定では、差が想定した向きに出ているかを平均値で自分で確かめてください。尾部と検定の種類に小数を入れると小数部分は切り捨てられ、検定の種類 1 で2つの範囲のデータ数が違うと #N/A になります。
例題2と例題3を、例題2の方法 A を A2:A7、方法 B を B2:B7、例題3の X を D2:D9、Y を E2:E5 に入力して計算すると、次のようになります(Excel で実際に計算し、scipy の計算と一致することを確かめた値です)。
=T.TEST(A2:A7, B2:B7, 2, 1)   → 0.000944   例題2・対応のある t 検定
=T.TEST(A2:A7, B2:B7, 2, 2)   → 0.980      例題2を誤って対応なしで検定した場合
=T.TEST(D2:D9, E2:E5, 2, 2)   → 0.0145     例題3・Student
=T.TEST(D2:D9, E2:E5, 2, 3)   → 0.136      例題3・Welch
T.TEST が返すのは t 値ではなく p 値
T.TEST の答えは p 値で、t 値そのものは出てきません。レポートに t 値と自由度を書く必要があるときは、上の式どおりに AVERAGE・STDEV.S・COUNT・SQRT で計算します。STDEV.S は n − 1 で割る標本標準偏差で、n で割る STDEV.P と取り違えないようにします。検量線の傾き・切片のように、t 検定とは別の計算を Excel でする方法はExcel の近似曲線の記事で扱っています。
1標本の t 検定は T.DIST.2T で p 値を出す
T.TEST は2つのデータ範囲を比べる関数で、1標本の形式がありません。t 値を式で計算し、両側 t 分布の関数 T.DIST.2T で p 値を求めます。例題1のデータを A2:A6 に入れた場合です。
平均       =AVERAGE(A2:A6)                                      → 10.09
標準偏差   =STDEV.S(A2:A6)                                      → 0.0464
t 値(C2) =(AVERAGE(A2:A6)-10)/(STDEV.S(A2:A6)/SQRT(COUNT(A2:A6))) → 4.34
p 値       =T.DIST.2T(ABS(C2), COUNT(A2:A6)-1)                  → 0.0123
臨界値     =T.INV.2T(0.05, 4)                                    → 2.776
別の方法として、B2:B6 に基準値 10 を5つ並べ、=T.TEST(A2:A6, B2:B6, 2, 1) と対応のある形式で計算しても、同じ p = 0.0123 になります(組ごとの差が「測定値 − 基準値」になり、1標本の t 検定と同じ計算になるため)。T.DIST.2T は x が負だと #NUM! を返すので、t が負になりうるときは ABS で絶対値にしてから渡します。T.INV.2T は両側の確率から臨界値を返す関数で、数表の代わりに使えます。
Welch の自由度を T.DIST.2T に渡してはいけない
Welch の t 検定の p 値を、手で計算した t と自由度から T.DIST.2T で求めようとすると、ずれが出ます。Microsoft の説明では T.DIST.2T の自由度は整数で指定する決まりで、実際に例題3の t = 2.0115、自由度 3.0526 を渡すと、自由度 3 のときと同じ 0.1378 が返りました(小数部分が切り捨てられる)。T.TEST の検定の種類 3 は 0.1362 を返し、これは非整数の自由度 3.0526 のまま計算した scipy の値と一致しました。Welch の p 値は T.TEST(検定の種類 3)で求めるのが安全です。T.INV.2T も同じく自由度が切り捨てられ、3.0526 を渡すと自由度 3 の臨界値 3.182 が返りました(自由度 3.05 の臨界値は 3.15)。
分析ツールを使う方法
Excel の分析ツールには「t 検定: 一対の標本による平均の検定」「t 検定: 等分散を仮定した 2 標本による検定」「t 検定: 分散が等しくないと仮定した 2 標本による検定」の3つがあり、それぞれ T.TEST の検定の種類 1・2・3 と同じ検定です。ただし Microsoft の説明では、分散が等しくないと仮定する t 検定ツールは自由度を最も近い整数に四捨五入するので、T.TEST(検定の種類 3)と結果が異なります。例題3では、ツールの自由度は 3.05 を四捨五入した 3 になり、自由度 3 で計算すると p = 0.1378、境界値 3.182 と、T.TEST の 0.1362 とわずかに違う値になります。分析ツールは最初は無効になっているので、Windows 版では [ファイル] → [オプション] → [アドイン] で、[管理] ボックスの [Excel アドイン] を選んで [設定] を押し、[分析ツール] にチェックを入れて有効にします。
p 値の正しい意味と、よくある誤解
アメリカ統計協会(ASA)は2016年に、p 値の誤用と誤解が広がっていることを受けて、p 値についての声明を出しました(Wasserstein と Lazar が The American Statistician に発表)。声明は p 値を、非公式には「特定の統計モデルのもとで、データの統計的な要約(たとえば2群の平均の差)が、観測された値と等しいか、それより極端になる確率」と説明しています。
t 検定に当てはめると、p 値は「帰無仮説(母平均の差は 0)と、検定の前提(独立性・正規分布など)がすべて正しいとしたとき、手元のデータ以上に大きな |t| が出る確率」です。図2で塗った両側の面積がこれに当たります。p 値が小さいことは、データがそのモデルと相容れにくいことを示しますが、どこが合わないのか(差があるのか、前提が崩れているのか)までは教えてくれません。
声明は6つの原則を挙げています。
- p 値は、データが特定の統計モデルとどれだけ相容れないかを示しうる
- p 値は、調べている仮説が正しい確率も、データが偶然だけで生じた確率も測らない
- 科学的な結論や、ビジネス・政策の判断を、p 値がある閾値を越えたかどうかだけで決めるべきではない
- 適切な推論には、完全な報告と透明性が必要である
- p 値や統計的有意性は、効果の大きさや結果の重要性を測らない
- p 値だけでは、モデルや仮説についての証拠のよい尺度にはならない
これを実験データの解析に当てはめると、よくある誤解は次のように整理できます。
| よくある誤解 | 正しくは |
|---|---|
| p = 0.012 だから、帰無仮説が正しい確率は 1.2% | p 値は帰無仮説が正しいと仮定して計算した確率で、仮説が正しい確率ではない(原則2) |
| p = 0.012 だから、差が偶然で生じた確率は 1.2% | これも原則2が否定している読み方。「偶然だけだとしたら、これ以上の差が出る確率」である |
| p が小さいほど差が大きい・重要だ | p はデータ数でいくらでも小さくなる。差の大きさは差そのものと信頼区間で示す(原則5) |
| p > 0.05 だから差は無い | 「差を見分けられなかった」だけ。例題3の信頼区間は −0.57〜2.57 と広い |
| p = 0.049 と p = 0.051 は結論が正反対 | 証拠の強さはほとんど同じ。0.05 の線だけで結論を決めない(原則3) |
| 有意になるまでデータを足したり、検定の種類を替えたりしてよい | 何回測り、何を除き、どの検定をいくつ試したかを報告しなければ、p 値は解釈できない(原則4) |
p 値は効果の大きさを表さない
1標本の t 検定で、基準値との差が 0.05、測定の標準偏差が 0.10 というまったく同じ状況を、データ数だけ変えて計算すると次のようになります(仮の値)。
| データ数 n | 3 | 10 | 30 | 100 |
|---|---|---|---|---|
| t 値 | 0.87 | 1.58 | 2.74 | 5.00 |
| p 値(両側) | 0.48 | 0.15 | 0.010 | 2.5 × 10⁻⁶ |
差の大きさは4列とも同じ 0.05 なのに、p 値は 0.48 から 2.5 × 10⁻⁶ まで変わります。t の分母 s/√n がデータ数とともに小さくなるからです。p 値が小さいことは「差が大きい」ことではなく、「差が 0 でないことを、このデータ数なら見分けられる」ことを意味します。逆に言えば、どんなに小さな差でも、データを十分に増やせば有意になります。その差が化学的に意味のある大きさかどうかは、別に判断しなければなりません。
信頼区間を一緒に報告する
差の大きさと不確かさを一度に示せるのが信頼区間です。平均(または平均の差)の 95% 信頼区間は、次の式で計算します。
平均(または差) ± t臨界値(両側 5%、その自由度) × 標準誤差

例題1:10.090 ± 2.776 × 0.02074 → 10.03〜10.15 mg/L(調製値 10.00 を含まない)
例題2:0.100 ± 2.571 × 0.01438  → 0.063〜0.137(0 を含まない)
例題3:1.00 ± 3.15 × 0.497      → −0.57〜2.57 mmol/L(0 を含む・Welch)
両側 5% の t 検定で有意になることと、95% 信頼区間が帰無仮説の値(差 0 や基準値)を含まないことは、同じ自由度と同じ標準誤差を使う限り一致します。信頼区間はそれに加えて、「差はおよそどのくらいか」「どこまでの大きさがありうるか」を示すので、p 値だけを書くより多くを伝えられます。グラフで平均と誤差棒を描くときに、誤差棒が標準偏差か標準誤差か信頼区間かを明記する理由も同じです(レポートの表・グラフの書き方)。
t 検定の前提と、外れ値の扱い
t 検定の計算は、次の前提の上に成り立っています。
- 独立性:各データが互いに独立に得られていること。同じ溶液を HPLC に3回注入した値は「注入のばらつき」の3回で、試料を3回調製した3回とは意味が違う。何を繰り返したかで、n が表すものと、検定で言えることが変わる
- 正規性:測定値(対応のある t 検定では差)が正規分布に従うこと。データが少ないと確かめにくいが、ランダムな誤差が積み重なった測定値は正規分布に近いことが多い。平均の分布は、データ数が増えるほど元の分布の形によらず正規分布に近づく
- 等分散:Student の t 検定だけの前提。Welch の t 検定を使えば外せる
外れ値は検定で機械的に捨てない
1つだけ大きく外れた値があると、平均も標準偏差も大きく動き、t 検定の結果を左右します。外れ値かどうかを判定する検定には Dixon の Q 検定や Grubbs の検定があり、Harvey の教科書は、ISO が Dixon の検定よりも Grubbs の検定を勧めていることを紹介しています。ただし Harvey は、外れ値の検定は慎重に使うべきで、外れ値を取り除くこと自体に慎重な統計学者もいる、とも述べています。
実験データでいちばん大事なのは、外れた理由を実験ノートで確かめることです。気泡の混入、ビュレットの読み違い、試料のこぼれなど、原因がはっきりしていれば除く根拠になります。原因がわからないまま、検定で有意になるように外れ値を除くのは、原則4の「完全な報告」に反します。除いたなら、何を、なぜ除いたかを必ず書きます。
3群以上を比べるときは t 検定を繰り返さない
3つの条件を比べるために、2つずつ組み合わせて t 検定を3回行うと、どの組も本当は差が無いときでも、どれか1つで偶然「有意」が出る確率が 5% より大きくなります。3回の検定が互いに独立だとして概算すると 1 − 0.953 = 14.3%、6回なら 26.5%、10回なら 40.1% です(実際の検定どうしは完全には独立でないので、これは目安です)。3群以上の平均を比べるときは、分散分析(ANOVA)と、多重比較の補正をした方法を使います。
試験・レポートでの問われ方
大学の分析化学・物理化学実験のレポートや院試では、t 検定は次のような形で問われます。
- 計算:データから平均・標準偏差・t 値・自由度を求め、数表の臨界値と比べて判定する(例題1〜3)。標準偏差を n − 1 で割ること、自由度を正しく数えることが採点の分かれ目
- 検定の選択:「同じ試料を2つの方法で測った」なら対応のある t 検定、「別々の試料」なら対応のない t 検定、と実験の設計から選べるか
- t 分布を使う理由:σ を s で推定するため、少数のデータでは正規分布より裾の重い t 分布を使う、と説明できるか
- 結論の書き方:「有意な差がある」「有意な差があるとはいえない」を区別し、「差が無い」と書かない
- p 値の意味:p 値が「帰無仮説が正しい確率」ではないことを説明する記述問題
レポートの考察で「文献値とずれたのは誤差のため」と書く代わりに、繰り返し測定のばらつきと比べて「このずれはばらつきの範囲か」を t 検定や信頼区間で示せると、考察が一段具体的になります(考察の文型は実験レポートの書き方)。測定値の桁の扱いは有効数字の記事、複数の測定値から計算した量の不確かさは誤差の伝播の記事で扱います。
まとめ
t 検定の式は、結局「見えている差は、平均がたまたま揺れる幅に比べて大きいか」という1つの問いを数にしたものです。どの検定を選ぶかは「その揺れをどう見積もるのが正しいか」の違いにすぎません。この見方を持っていれば、対応のある検定が強い理由も、Welch を勧める理由も、p 値が差の大きさを表さない理由も、同じ1本の筋で説明できます。
よくある質問
t 検定は、2つの平均の差(または平均と基準値の差)が、測定のばらつきによる偶然で説明できる大きさかどうかを判定する方法です。差を標準誤差(標準偏差 ÷ √データ数)で割った t 値を求め、自由度に応じた t 分布と比べて p 値や臨界値で判定します。比べる対象とデータの組み方によって、1標本の t 検定、対応のある t 検定、対応のない t 検定(Student と Welch)を使い分けます。
データが1対1の組になっているかどうかで決めます。同じ試料を2つの方法で測った、同じ試料の処理前と処理後を測った、のように組がある場合は、組ごとの差をとる対応のある t 検定を使います。別々に用意した試料や、別々の実験者が独立に測った結果なら、対応のない t 検定を使います。数値を見てではなく、実験の設計から判断します。対応のあるデータを対応なしで検定すると、試料ごとの違いが差を隠し、本当の差を見逃しやすくなります。
2群の分散が等しいと言える確かな理由が無ければ、Welch の t 検定を使うのが基本です。Student の t 検定は2群の分散を合算するので、データ数の少ない群のばらつきが大きいと、差を過大に評価しやすくなります。Welch の t 検定は分散を別々に使い、自由度を Welch–Satterthwaite の式で補正するので、分散が違っても使え、分散が等しい場合でも失うものはわずかです。先に F 検定で分散を調べてから選ぶ方法は勧められていません。
T.TEST(配列1, 配列2, 尾部, 検定の種類) の尾部には、片側検定なら 1、両側検定なら 2 を入れます。差の向きをデータを見る前に決めている場合以外は 2 を使います。検定の種類は、対応のあるデータなら 1、等分散を仮定する2標本(Student)なら 2、等分散を仮定しない2標本(Welch)なら 3 です。T.TEST が返すのは t 値ではなく p 値です。T.TEST には1標本の形式が無いので、1標本の t 検定は t 値を式で計算して T.DIST.2T で p 値を求めます。
言えません。p 値が 0.05 より大きいことは、そのデータの量とばらつきでは差を見分けられなかったことを意味するだけで、差が無いことの証明にはなりません。「有意な差があるとはいえない」と書き、平均の差の信頼区間を添えて、どの程度の差までありうるかを示します。信頼区間が広ければ、データ数を増やすか、ばらつきの原因を減らす必要があります。
参考文献
- D. Harvey, Analytical Chemistry 2.1, §4.6 Statistical Methods for Normal Distributions(LibreTexts)
- NIST/SEMATECH, e-Handbook of Statistical Methods, §1.3.5.3 Two-Sample t-Test for Equal Means
- R. L. Wasserstein, N. A. Lazar, “The ASA’s Statement on p-Values: Context, Process, and Purpose”, The American Statistician 2016, 70, 129–133
- Student, “The Probable Error of a Mean”, Biometrika 1908, 6, 1–25
- B. L. Welch, “The Generalization of ‘Student’s’ Problem when Several Different Population Variances are Involved”, Biometrika 1947, 34, 28–35
- F. E. Satterthwaite, “An Approximate Distribution of Estimates of Variance Components”, Biometrics Bulletin 1946, 2, 110–114
- G. D. Ruxton, “The unequal variance t-test is an underused alternative to Student’s t-test and the Mann–Whitney U test”, Behavioral Ecology 2006, 17, 688–690
- M. Delacre, D. Lakens, C. Leys, “Why Psychologists Should by Default Use Welch’s t-test Instead of Student’s t-test”, International Review of Social Psychology 2017, 30, 92–101
- Microsoft サポート「T.TEST 関数」「T.DIST.2T 関数」「T.INV.2T 関数」「分析ツールを使用して統計学的および工学的分析を行う」
- GraphPad Prism Statistics Guide, “The unequal variance Welch t test”
関連記事
機器分析の全体像は機器分析総まとめ、実験操作は有機化学実験の基本操作まとめにまとめています。
- 標準偏差と標準誤差の違い(相対標準偏差・変動係数)
- 最小二乗法(傾き・切片の式と導出・Excel)
- 誤差の伝播と不確かさ(実験値の誤差の計算)
- レポートの表・グラフの書き方|表題の位置・軸の単位・有効数字・誤差棒
- 検出限界と定量限界の違いと求め方|S/N比・3.3σ/S・分析法バリデーション
- Excel(エクセル)の近似曲線|6種類の選び方・数式とR2乗値・検量線の例
- 実験レポートの書き方|テンプレートと考察の例文【有機化学実験の記入例】