最小二乗法とは?傾きと切片の式の導出・標準誤差・決定係数とExcelの関数
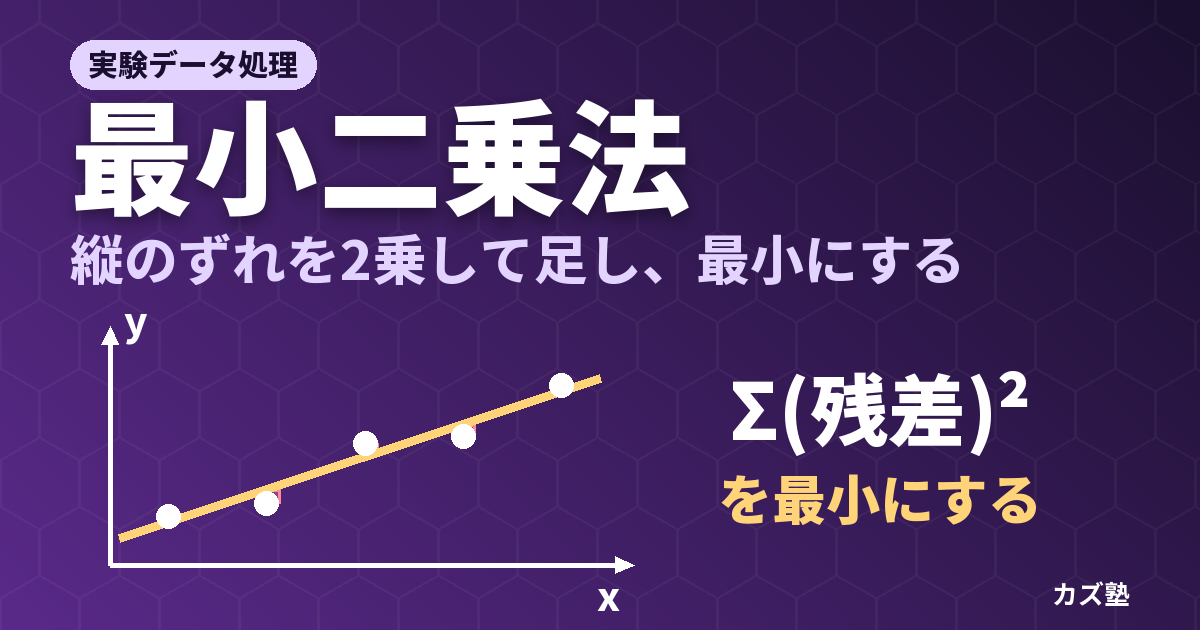
方眼紙に5つの測定点を打ち、定規で直線を引いてみてください。隣の人にも同じ点で引いてもらうと、傾きは少しずつ違うはずです。どちらの線が「正しい」かは、目で見ても決められません。決めるには、「よく合っている」とはどういうことかを数で定義する必要があります。その定義の1つが最小二乗法で、Excel の近似曲線も、検量線の傾きも、アレニウスプロットの活性化エネルギーも、この定義で計算されています。
公式は Excel が一瞬で計算してくれます。それでも試験やレポートで困るのは、「なぜ2乗なのか」「なぜ n − 2 で割るのか」「R2 = 0.999 なら安心してよいのか」と聞かれたときです。この記事では、残差の2乗の和を微分して公式を自分で導き、そこから傾き・切片の誤差、検量線で読んだ濃度の不確かさ、決定係数の意味と限界までを1本の筋でつなげます。最後に、同じ計算を Excel の関数で確かめる方法をまとめます。
最小二乗法とは:残差の2乗の和を最小にする
測定点が n 個あり、それぞれ (xi, yi) とします。ここに直線 y = b0 + b1x を当てはめたいとき、最小二乗法は次の量 S が最も小さくなる b0(切片)と b1(傾き)を選びます。
直線上の値(予測値)    ŷi = b0 + b1xi
残差                    ri = yi − ŷi
残差平方和              S = Σ ri2 = Σ (yi − b0 − b1xi)2   (i = 1 〜 n の和)
英語では method of least squares(least squares method)と呼び、「二乗」を「2乗」と書いて最小2乗法と表記する教科書もあります。指しているものは同じです。
残差:測定値と直線の縦のずれ
残差(residual)は、測定値 yi から、同じ xi での直線上の値 ŷi を引いたものです。グラフの上では、点から直線へ縦にまっすぐ引いた線分の長さ(符号つき)に当たります。点が直線より上なら正、下なら負です。
図1は、あとの例題1で使う5点のデータに最小二乗法の直線を引き、右側で残差を拡大して描いたものです。残差を1辺とする正方形の面積が残差の2乗で、5つの正方形の面積の合計が S です。最小二乗法は、この面積の合計がいちばん小さくなる直線を選ぶ方法、と言い換えられます。
なぜ「2乗」して足すのか
ずれをそのまま足すと、正と負が打ち消し合います。実際、あとで示すとおり最小二乗法の直線では残差の和はちょうど 0 になり(図1でも −0.06 + 0.07 − 0.10 + 0.23 − 0.14 = 0)、さらに言えば、重心を通る直線なら傾きがいくらでも残差の和は 0 です。和そのものは「合い具合」の物差しになりません。符号を消す方法には2乗のほかに絶対値もありますが、2乗が選ばれるのには理由があります。
- 微分できて、答えが式で書ける:S は b0・b1 の2次式なので、微分して 0 とおくと連立1次方程式になり、傾きと切片が公式として1組に決まります。絶対値の和は 0 のところで折れ曲がって微分できず、解析的な解き方がありません。点の並び方によっては、和を最小にする直線が1本に決まらないこともあります(Wikipedia の Least absolute deviations の項)。
- 大きなずれほど重く罰する:ずれ 0.2 の2乗は 0.04 で、ずれ 0.1 の2乗 0.01 の4倍です。1点だけ大きく外れるより、全体が少しずつずれるほうを選びます。裏を返すと外れ値に引っぱられやすいということでもあり、絶対値の和を使う方法はその点で外れ値に強いとされます。
- 誤差が正規分布なら、最も確からしい直線になる:各点の測定値のばらつきが同じ大きさの正規分布に従い、互いに独立なとき、残差平方和を最小にする直線は、そのデータが得られる確率を最大にする直線(最尤推定)と一致します。さらに、誤差の平均が 0 で、互いに無相関で、ばらつきの大きさがどの点でも同じなら、正規分布でなくても、最小二乗法は「データの1次式で表せる偏りのない推定法のうち、ばらつきが最小のもの」(最良線形不偏推定量)になります。ガウス・マルコフの定理と呼ばれる結果です。
例題1のデータで比べると、残差の絶対値の和を最小にする直線は y = 1.95x + 0.05 で、最小二乗法の y = 1.97x + 0.09 とは少し違います。どちらも「よく合う直線」ですが、合い具合の定義が違うので答えも違う、ということです。
歴史を少しだけ添えると、最小二乗法を最初に明快な形で公表したのはルジャンドル(1805年)で、ガウスは1809年に天体の軌道の計算法を発表した際、1795年からこの方法を使っていたと主張しました。正規分布との結びつきを示したのもガウスです。
なぜ「縦方向」のずれなのか
残差を縦方向にとるのは、誤差は y の側にだけあり、x の値は正確に分かっているという前提を置いているからです。検量線なら、横軸は正確に調製した標準液の濃度、縦軸は測るたびにばらつく吸光度やピーク面積です。x が正確なら、点が直線からずれる理由は y の測定誤差だけなので、ずれは縦に測るのが筋です。
x と y を入れ替えて、「x を y から予測する直線」(横方向のずれを最小にする直線)を求めると、一般には別の直線になります。例題1のデータでは、y を x に回帰した直線の傾きは 1.97、x を y に回帰した直線を y = … の形に直したときの傾きは 1.9746 です。2本の傾きが一致するのは、全点が完全に一直線に並ぶときだけです。実は、y を x に回帰した傾き(1.97)と x を y に回帰した傾き(0.50643)の積は 0.99766 で、あとで扱う決定係数 R2 にちょうど等しくなります。点がばらつくほど R2 が小さくなり、2本の直線の差が開きます。
x の側にも無視できない誤差があるのに、そのまま最小二乗法を使うと、傾きは本来の値より 0 の側に偏ります(回帰希釈と呼ばれる現象)。検量線で「濃度を横軸に置く」のは慣習ではなく、この前提に合わせるためです(理由は検量線の記事とExcel の近似曲線の記事でも触れています)。
傾きと切片の公式を導く(正規方程式)
公式を覚えるより、導けるようにしておくほうが確実です。手順は「S を b0 と b1 でそれぞれ偏微分して 0 とおく」だけです。
偏微分して 0 とおく
S は b0 と b1 の2変数の関数です。最小になる点では、どちらの方向に少し動かしても S は(1次の範囲で)変わらないので、2つの偏微分がともに 0 になります。
S = Σ (yi − b0 − b1xi)2

∂S/∂b0 = −2 Σ (yi − b0 − b1xi)       = 0   ……(1)
∂S/∂b1 = −2 Σ xi(yi − b0 − b1xi)   = 0   ……(2)

−2 で割って和をばらすと(Σb0 = n b0 に注意)

n b0       + (Σxi) b1   = Σyi
(Σxi) b0 + (Σxi2) b1 = Σxiyi
この2本の連立1次方程式を正規方程式(normal equations)と呼びます。必要なのは n、Σxi、Σyi、Σxi2、Σxiyi の5つの数だけです。
連立方程式を解く:2つの形の公式
1本目に Σxi を、2本目に n を掛けて引き算し、b0 を消すと、傾きが出ます。
       n Σxiyi − Σxi Σyi
b1 = —————————————————          b0 = (Σyi − b1Σxi) / n = y − b1x
       n Σxi2 − (Σxi)2
ここで x・y は x と y の平均です。平均からの偏差を使って書き直すと、意味が見やすい形になります。
Sxx = Σ(xi − x)2         = Σxi2 − (Σxi)2/n        (x の偏差平方和)
Sxy = Σ(xi − x)(yi − y)  = Σxiyi − ΣxiΣyi/n     (偏差の積和)

b1 = Sxy / Sxx          b0 = y − b1x
傾きは「x と y が一緒に平均から同じ向きにずれる度合い(Sxy)」を「x の散らばり(Sxx)」で割ったもの、と読めます。x が大きいときに y も大きい点が多ければ Sxy は正、逆なら負です。Harvey の教科書(式5.4・5.5)は和の形で、Microsoft の INTERCEPT 関数の解説は偏差の形で、同じ傾きと切片の式を示しています。
本当に最小になっているのか
微分が 0 になる点は、最小とは限らず最大のこともあります。最小二乗法の場合は心配いりません。S は b0・b1 の2次式で、2乗の項の係数が正(下に凸)だからです。図2は、例題1のデータで直線を重心に固定したまま傾き b1 だけを動かし、S を計算したものです。
放物線の式は S = 0.091 + 10 × (b1 − 1.97)2 で、10 は例題1の Sxx です。底で接線が水平になる点が「微分 = 0」の点で、そこがただ1つの最小点です。一般に、2変数の2次式が下に凸である条件を確かめると、nΣxi2 − (Σxi)2 = nSxx > 0 になります。これが成り立たないのは、すべての x が同じ値のとき(Sxx = 0)だけです。全部の点が同じ濃度なら傾きを決めようがない、という当たり前のことが、公式の分母が 0 になる形で現れています。Microsoft の SLOPE 関数の解説にも、既知の y がすべて 0、既知の x がすべて 1 のデータでは SLOPE と INTERCEPT が #DIV/0! を返す、という例が載っています。
公式から読める3つの性質
正規方程式そのものが、最小二乗法の直線の性質を表しています。
- 直線は必ず重心 (x, y) を通る:b0 = y − b1x を書き直すと y = b0 + b1x。図2の右で、どの傾きの直線も重心を軸に回していたのはこのためです。
- 残差の和は 0:式(1) は Σri = 0 そのものです。
- 残差と x の積の和も 0:式(2) は Σxiri = 0 です。残差に x と同じ向きの傾向が残っていれば、傾きを変えてもっと S を減らせるはずなので、最小点では残差と x の「相関」が消えている、と読めます。
この3つ目の性質から、残差には「直線で説明できる傾向」はもう残っていないことになります。それでも残差に弓形のような規則的な並びが見えるなら、それは直線では表せない形(曲がり)があるサインです。この考え方が、あとで出てくる残差プロットの根拠です。
測定値を縦に並べたベクトルを y、1 と xi を横に並べた行を縦に積んだ行列を X、係数を b = (b0, b1) とすると、正規方程式は XTX b = XTy と1行で書けます。X の列を増やせば、x が2つ以上ある重回帰や、x2 の列を加えた2次式の当てはめも同じ式で解けます。Excel の LINEST 関数が複数の x の列を受け取れるのはこのためです。なお、ここでいう「線形」は、求める係数 b について1次という意味です。y = b0 + b1x + b2x2 はグラフが曲線でも、係数については1次なので線形の最小二乗法で解けます(Harvey も同じ注意をしています)。
例題1:5点のデータで傾きと切片を手計算する
以下の例題の数値は、計算の練習のために作った仮の値です。すべて Python で計算し直して確かめています。
例題1:次の5点に最小二乗法で直線 y = b0 + b1x を当てはめ、傾き・切片・残差・残差平方和を求めよ。
| x | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| y | 2.0 | 4.1 | 5.9 | 8.2 | 9.8 |
① 5つの和を作る:n = 5、Σx = 15、Σy = 30.0、Σx2 = 55、Σxy = 2.0 + 8.2 + 17.7 + 32.8 + 49.0 = 109.7。
② 傾き:b1 = (5 × 109.7 − 15 × 30.0) / (5 × 55 − 152) = 98.5 / 50 = 1.97。偏差の形でも Sxx = 55 − 225/5 = 10、Sxy = 109.7 − 450/5 = 19.7 から 19.7 / 10 = 1.97。
③ 切片:x = 3、y = 6.0 なので b0 = 6.0 − 1.97 × 3 = 0.09。直線は y = 1.97x + 0.09。
④ 残差:直線上の値は 2.06、4.03、6.00、7.97、9.94 なので、残差は −0.06、+0.07、−0.10、+0.23、−0.14。和は 0、x との積の和も −0.06 + 0.14 − 0.30 + 0.92 − 0.70 = 0 で、正規方程式の性質どおり。
⑤ 残差平方和:S = 0.0036 + 0.0049 + 0.0100 + 0.0529 + 0.0196 = 0.091。
手計算のこつは、②で「和の形」と「偏差の形」の両方を計算して突き合わせることです。Σxy の掛け算を1つ間違えても、2つの形で同じ間違いをすることはまずありません。また、x の散らばりに比べて平均が 0 から遠いデータ(例えば 300〜340 K で測ったアレニウスプロットの 1/T は、0.00294〜0.00333 と平均の 0.0031 のまわりにわずかに散らばるだけ)では、和の形 nΣx2 − (Σx)2 がほとんど同じ大きさの数どうしの引き算になり、途中で桁を落とすと答えが大きく狂います。300, 310, 320, 330, 340 K の5点なら、Σx2 は Sxx の約511倍もあり、引き算で上の2〜3桁が消えます。この比は x を定数倍しても変わらないので、1/T を 103/T に直すだけでは解決しません(見やすくはなります)。効くのは、偏差の形で計算するか、x から適当な定数を引いてから計算する(例えば x − 0.0030 にすると比は約1.9まで下がる)ことです。定数を引いても傾きは変わりません。
傾きと切片の標準誤差
例題1の傾きは 1.97 でしたが、同じ実験をもう一度すれば、測定値のばらつきのせいで別の値になります。傾きがどのくらい信用できるかを表すのが標準誤差です。Harvey の教科書(式5.6〜5.8)の形で書くと、次の3つの式になります。
残差の標準偏差    sr  = √[ Σ(yi − ŷi)2 / (n − 2) ] = √[ S / (n − 2) ]
傾きの標準誤差    sb1 = sr / √Sxx
切片の標準誤差    sb0 = sr × √[ Σxi2 / (n Sxx) ]
残差の標準偏差:なぜ n − 2 で割るのか
sr は、点が直線のまわりにどのくらい散らばっているか、つまり y の測定のばらつきの大きさを見積もる量です。ふつうの標準偏差は n − 1 で割りますが、ここでは n − 2 で割ります。
理由は、残差には2つの縛りがかかっているからです。正規方程式から、残差は Σri = 0 と Σxiri = 0 を必ず満たします。n 個の残差のうち、自由に動けるのは n − 2 個だけで、残りの2個は自動的に決まってしまいます。傾きと切片の2つをデータから決めたぶん、直線はデータに「寄せて」引かれているので、残差は本当の誤差より小さめに出ます。n で割ると、ばらつきを小さく見積もってしまうのです。自由度 n − 2 で割ると、この寄せた分がちょうど補正されます。平均値1つを決める標準偏差が n − 1 で割る理由と同じ考え方で、詳しくは標準偏差と標準誤差の記事で扱います。
点が2個しかなければ、直線は必ず2点を通り、残差はどちらも 0 で、自由度も 0 です。ばらつきについての情報が何も無いので、sr は計算できません。Excel の STEYX 関数(予測値の標準誤差)が、データが3個未満だとエラーを返すのはこのためです。
傾きの標準誤差:x を広く散らすほど小さくなる理由
公式の Sxx は、どこから出てくるのでしょうか。傾きの式 b1 = Sxy/Sxx は、Σ(xi − x) = 0 を使うと次のように書き直せます。
b1 = Σ (xi − x) yi / Sxx

各 yi のばらつきが同じ大きさ σ で、互いに独立なら
Var(b1) = Σ (xi − x)2 σ2 / Sxx2 = σ2 / Sxx

σ を sr で見積もれば     sb1 = sr / √Sxx
つまり傾きは、各測定値 yi に「重み (xi − x)」を掛けて足したものです。重心から遠い点ほど重みが大きく、傾きを強く決めています。シーソーの両端に乗った人ほど傾きを大きく変えられるのと同じです。逆に言えば、x を広い範囲に散らすほど Sxx が大きくなり、傾きの誤差は小さくなります。点を増やしても Sxx は増えますが、同じ範囲の中で点を増やすより、範囲そのものを広げるほうが効きます(ただし、直線とみなせる範囲を超えてはいけません)。Harvey の教科書も、標準を広い濃度範囲に散らすと傾きと切片の不確かさが小さくなるとしています。
切片の標準誤差:原点が重心から遠いほど大きくなる
切片 b0 = y − b1x は「重心の高さ」から「傾き × 重心までの距離」を引いたものです。重心の高さ y のばらつきは σ2/n、傾きのばらつきは σ2/Sxx で、2つは互いに独立なので、分散を足して
Var(b0) = σ2/n + x2 σ2/Sxx = σ2 (Sxx + n x2) / (n Sxx) = σ2 Σxi2 / (n Sxx)
となります(Sxx + nx2 = Σxi2)。第2項 x2σ2/Sxx は、重心から x = 0 まで直線を延ばしたとき、傾きのわずかな誤差が距離 x の分だけ拡大されて切片に響く効果です。測定範囲が原点から遠いデータ(例えば 1/T が 0.003 前後のアレニウスプロット)で切片の誤差がとても大きくなるのはこのためで、Harvey も、切片の不確かさを小さくするには低濃度の標準を含めるとよいとしています。
信頼区間:t 分布の自由度は n − 2
標準誤差が分かれば、「真の傾きがこの範囲にあると 95% の確からしさで言える」という信頼区間を作れます。
傾き    b1 ± t × sb1
切片    b0 ± t × sb0        (t は自由度 n − 2・両側 95% の t 分布の値)
σ を sr で「見積もって」いるので、正規分布の 1.96 ではなく、自由度 n − 2 の t 分布の値を使います。点が少ないほど sr 自体が当てにならないので、t が大きくなり、区間は広がります。自由度 4 なら t = 2.776、自由度 3 なら 3.182、自由度 1 なら 12.706 です。t 分布と自由度の考え方はt 検定の記事で詳しく扱います。
例題1に当てはめると、sr = √(0.091/3) = 0.174、sb1 = 0.174/√10 = 0.0551、sb0 = 0.174 × √(55/50) = 0.183 です。自由度 3 の t = 3.182 を使うと、傾きは 1.97 ± 0.18、切片は 0.09 ± 0.58(95% 信頼区間)になります。切片の区間は 0 を含むので、このデータからは「切片は 0 と区別できない」と言えます。
例題2:検量線の傾き・切片と、読み取った濃度の不確かさ
化学の実験でいちばんよく使う場面、検量線で確かめます。吸光度と濃度が比例する理由はランベルト・ベールの法則の記事を参照してください。
例題2:ある化合物の標準液を光路長 1.00 cm のセルで測り、次の吸光度を得た。未知試料を3回測った吸光度は 0.252、0.249、0.255 だった。(1)検量線の傾きと切片、それぞれの95%信頼区間を求めよ。(2)切片は 0 と区別できるか。(3)未知試料の濃度とその95%信頼区間を求めよ。
| 濃度(mg L−1) | 0 | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 |
|---|---|---|---|---|---|---|
| 吸光度 | 0.004 | 0.102 | 0.199 | 0.301 | 0.398 | 0.503 |
(1)n = 6、Σx = 15、Σy = 1.507、Σx2 = 55、Σxy = 5.510 から、Sxx = 17.5、Sxy = 1.7425。傾き b1 = 1.7425/17.5 = 0.09957 L mg−1、切片 b0 = 0.25117 − 0.09957 × 2.5 = 0.00224。残差は +0.0018、+0.0002、−0.0024、0.0000、−0.0025、+0.0029 で、残差平方和 2.362 × 10⁻⁵、sr = √(2.362 × 10⁻⁵/4) = 0.00243。sb1 = 0.00243/√17.5 = 0.00058、sb0 = 0.00243 × √(55/(6 × 17.5)) = 0.00176。自由度 4 の t = 2.776 を掛けて、傾き 0.0996 ± 0.0016 L mg−1、切片 0.0022 ± 0.0049。
(2)切片 0.0022 は標準誤差 0.0018 の 1.27 倍しかなく、t = 2.776 より小さい(信頼区間 −0.0026〜+0.0071 が 0 を含む)。このデータからは切片は 0 と区別できない。
(3)未知試料の平均 y0 = 0.252 から x0 = (0.252 − 0.00224)/0.09957 = 2.508 mg L−1。下の式で sx0 = 0.0173 mg L−1、95% 信頼区間は 2.508 ± 2.776 × 0.0173 = 2.51 ± 0.05 mg L−1。
(2)のように「切片が 0 と区別できるか」を先に確かめるのが、切片を 0 に固定するかどうかを決めるときの正しい順番です。Excel の近似曲線で切片を 0 に固定したときに何が起こるか(R2 の定義が変わる)は、Excel の近似曲線の記事の「切片を0に固定してよいか」の節で数値例を示しています。
検量線から読んだ濃度の不確かさ
(3)で使った式は、Harvey の教科書の式5.12 と同じものです。
x0 = (y0 − b0) / b1

          sr      1     1     (y0 − y)2
sx0 = ——— √[ —— + —— + ——————————— ]
          b1      m     n     b12 Sxx

m:未知試料を測った回数 n:標準の点の数 y0:未知試料の信号の平均 y:標準の信号の平均
この式は暗記するより、根号の中の3つの項が3つの誤差の源だと読むと忘れません。直線は重心を通るので、x0 = x + (y0 − y)/b1 と書けます。この式の3つの部品のばらつきを、誤差の伝播の規則で足し合わせると上の式になります。
- 1/m:未知試料そのものの測定のばらつき。測る回数 m を増やせば小さくなる
- 1/n:直線の「高さ」(重心の位置)の不確かさ。標準の点を増やせば小さくなる
- (y0 − y)2/(b12Sxx):直線の「傾き」の不確かさ。重心から離れた所で読むほど、傾きのわずかな誤差が拡大される
例題2の検量線で、読む位置を変えて計算すると、3回測定の平均で sx0 は濃度 0.48 mg L−1(吸光度 0.050)で 0.0209、重心に近い 2.51 mg L−1 で 0.0173、4.80 mg L−1(吸光度 0.480)で 0.0219 となり、重心の付近で最も小さくなります。また、未知試料を1回しか測らなければ(m = 1)、重心付近でも 0.0264 に増えます。試料は検量線の真ん中に来るように希釈し、繰り返し測るのがよいという実験の常識は、この式から出てきます(検量線の記事で、外挿してはいけない理由として説明している内容の定量版です)。
検出限界・定量限界を検量線から求めるときに出てくる「残差の標準偏差」も、ここで計算した sr のことです(検出限界と定量限界の記事)。
決定係数 R2 の意味と限界
Excel のグラフに必ず一緒に表示される R2(決定係数、coefficient of determination)は、最小二乗法の副産物です。意味を式から確かめておきます。
R2 は「y のばらつきのうち、直線で説明できた割合」
測定値 yi が平均 y からどれだけ散らばっているかを、3つに分けます。
yi − y = (ŷi − y) + (yi − ŷi)
         直線で説明  残差

両辺を2乗して足すと
Σ(yi − y)2 = Σ(ŷi − y)2 + Σ(yi − ŷi)2
 総平方和 SStot   回帰平方和 SSreg  残差平方和 SSres

R2 = SSreg / SStot = 1 − SSres / SStot
2乗して足したときに交差項 2Σ(ŷi − y)ri が消えるのがポイントです。ŷi − y = b1(xi − x) なので、交差項は 2b1Σ(xi − x)ri で、正規方程式(Σri = 0 と Σxiri = 0)からちょうど 0 になります。この分解がきれいに成り立つのは、最小二乗法で、しかも切片を求めた直線だからです。例題1では SStot = 38.9、SSres = 0.091 なので R2 = 1 − 0.091/38.9 = 0.99766 です。
切片を求めた直線の当てはめでは、R2 は x と y の相関係数 r(ピアソンの積率相関係数)の2乗に等しくなります。Excel の RSQ 関数が「ピアソンの積率相関係数の2乗」を返し、それが LINEST の r2 と一致するのはこのためです。また SSreg = b12Sxx なので、次の形にも書けます。
R2 = b12 Sxx / (b12 Sxx + SSres)
この式が、R2 の限界を考える手がかりになります。R2 は「測定のばらつき(SSres)」だけでなく、「x をどれだけ広く散らしたか(Sxx)」でも変わるのです。
限界1:直線が正しい形かどうかは分からない
統計学者アンスコムは1973年の論文で、回帰直線も R2 もほぼ同じなのに、グラフにするとまったく違う4組のデータを示しました。図3は、その公表データを Python で計算し直して描いたものです。4組とも11点で、回帰直線は y = 3.00 + 0.500x、R2 = 0.67 です。
データ I は想定どおりの「直線+ばらつき」ですが、II は曲線で、直線という式の形そのものが間違っています。III はほぼ一直線の点に1つだけ外れ値があり、2乗の罰のせいで直線がそちらに引っぱられています。IV は x = 19 の1点だけが傾きを決めていて、その点を除けば x は全部同じ値です(先ほど見たとおり、x が全部同じなら傾きは決まりません)。R2 は、これらの違いを1つも教えてくれません。見分ける方法は、点そのものと、残差を x に対してプロットしたグラフ(残差プロット)を見ることです。Harvey の教科書は、残差プロットに曲がった並びが見えれば直線が不適切のサイン、濃度が高いほど残差が大きくなっていけば信号の誤差が濃度に依存しているサインで、その場合は重み付き回帰(次の節)を使うとしています。
限界2:x の範囲を変えるだけで R2 は変わる
例題3:例題2と同じ化合物の標準液を、濃度 0、0.2、0.4、0.6、0.8、1.0 mg L−1 の狭い範囲で測り、吸光度 0.004、0.022、0.040、0.062、0.079、0.105 を得た。傾き・残差の標準偏差 sr・傾きの標準誤差・R2 を求め、例題2と比べよ。
Sxx = 0.7、傾き b1 = 0.09971 L mg−1、切片 0.00214、sr = 0.00255、sb1 = 0.00304、R2 = 0.99629。例題2(0〜5 mg L−1)は sr = 0.00243、sb1 = 0.00058、R2 = 0.99986。測定のばらつき sr はほぼ同じなのに、R2 は狭い範囲のほうが低く、傾きの相対標準誤差は 3.1% と、例題2の 0.58% の約5倍になる。Sxx が 17.5 から 0.7 へ25分の1になり、sb1 は √25 = 5 倍になったため。
2つの検量線で、吸光度計の性能(sr)は変わっていません。R2 が下がったのは、測り方が悪くなったからではなく、x の範囲を狭めて Sxx が小さくなり、R2 の式の分子 b12Sxx が縮んだからです。逆に、範囲を広げれば R2 は簡単に 1 に近づきます。「R2 が 0.999 以上だからこの測定は精度が高い」という言い方が危ういのはこのためです。
限界3:点の数を書かないと、傾きの精度は分からない
標準誤差の式と R2 の式を組み合わせると、傾きの相対標準誤差は次の形になります(Python で例題1〜3のすべてで一致を確かめました)。
sb1 / b1 = √[ (1 − R2) / ((n − 2) R2) ]
同じ R2 = 0.999 でも、点が3個なら傾きの相対標準誤差は 3.2% で、自由度 1 の t = 12.706 を掛けると95%信頼区間は ±40% にもなります。点が10個なら相対標準誤差 1.1%、t = 2.306 で ±2.6% です。R2 だけを書いて点の数を書かないと、読み手には傾きの精度が判断できません。レポートでは「傾き 0.0996 ± 0.0016(95% 信頼区間、n = 6)」のように、傾きそのものの不確かさと点の数を書くのが確実です。
限界4:切片を 0 に固定した R2 は別物
切片を 0 に固定すると、先ほどの分解の交差項が 0 にならないので、同じ定義は使えません。Microsoft の LINEST 関数の解説によると、定数を FALSE(切片 0)にした場合、総平方和は平均からの偏差ではなく y の値そのものの2乗の和で計算されます。0 からの大きさで比べるので値が大きく出やすく、通常の R2 と比べても意味がありません。
最小二乗法の前提と、崩れたときの対処
ここまでの公式、とくに標準誤差と信頼区間は、いくつかの前提の上に成り立っています。Harvey の教科書が挙げる重みなし回帰の前提(誤差は y だけにある・誤差は正規分布・誤差の大きさは x によらない)に、測定の独立性と式の形を加えて整理します。
| 前提 | 崩れると何が起こるか | 確かめ方・対処 |
|---|---|---|
| 式の形が正しい(本当に直線) | 傾き・切片に物理的な意味がなくなる。R2 は高いままのことがある | 残差プロットの弓形を見る。直線の範囲に絞る、理論式に合わせて変数を変換する |
| x に誤差が無い(y に比べて無視できる) | 傾きが 0 の側に偏る(回帰希釈) | 正確に分かっている量を横軸に置く。標準液は正確に調製する |
| 誤差の大きさがどの点でも同じ(等分散) | ばらつきの小さい点も大きい点も同じ重みで扱われ、標準誤差・信頼区間が正しくなくなる | 残差プロットで、濃度が高いほど残差が大きくなっていないかを見る。重み付き最小二乗法を使う |
| 各点の誤差が互いに独立 | 隣どうしの誤差が同じ向きにずれる(正の相関がある)と、ばらつきを小さく見積もり、信頼区間が狭すぎる。装置のドリフトは、濃度順に測ると主に傾きの偏りとして効く | 測定の順番を濃度順に固定しない(ドリフトが傾きに乗るのを防ぐ)。標準液は1本ずつ独立に調製する |
| 誤差が正規分布に従う | 傾き・切片の値は使えるが、t 分布による信頼区間の根拠が弱くなる | 外れ値が無いかを確かめる。除くなら理由をレポートに書く |
重み付き最小二乗法:ばらつきが濃度とともに大きくなるとき
濃度の範囲が何桁にもわたる検量線では、吸光度やピーク面積のばらつきが、濃度にほぼ比例して大きくなることがよくあります。このまま重みなしで当てはめると、ばらつきの大きい高濃度の点に直線が引っぱられ、精度の良い低濃度の点が軽く扱われます。そこで、各点の残差の2乗に、その点の分散の逆数 wi = 1/si2 を掛けてから足し、それを最小にします。
Sw = Σ wi (yi − b0 − b1xi)2       wi = 1 / si2

同じように偏微分して 0 とおくと
       Σwi Σwixiyi − Σwixi Σwiyi
b1 = ———————————————————————      b0 = (Σwiyi − b1Σwixi) / Σwi
       Σwi Σwixi2 − (Σwixi)2
すべての wi が等しければ、重みなしの公式(Σwi が n になる)に戻ります。Harvey の教科書は重みの合計が n になるように規格化した形(式5.13〜5.15)で書いていますが、重みを定数倍しても傾きと切片は変わらないので、上の式と同じ答えになります。
例題4:濃度 1.0、2.0、5.0、10.0、20.0 mg L−1 の標準液の吸光度が 0.051、0.098、0.252、0.497、1.010 で、繰り返し測定から見積もった各点の標準偏差が 0.002、0.004、0.010、0.020、0.040(濃度に比例)だった。重みなしと重み付きで直線を求め、吸光度 0.075 の試料の濃度を比べよ。
重みなし:b1 = 0.05048、b0 = −0.00206 で、吸光度 0.075 の試料は 1.527 mg L−1。重み付き(wi = 1/si2):b1 = 0.04991、b0 = 0.00057 で 1.491 mg L−1。低濃度の試料では約2.4% の差になる。重みなしでは、ばらつきの大きい 20 mg L−1 の点(標準偏差 0.040)にも他の点と同じ重みがかかっている。各点の残差をその点の標準偏差で割って比べると、重みなしでは 1 mg L−1 の点が +1.29(残差 +0.0026)と、ばらつきの1倍を超えて外れているのに対し、重み付きでは5点すべてが絶対値で 0.6 以下にそろう(1 mg L−1 の点の残差は +0.0005 に縮む)。重み付きは、各点をそのばらつきに見合った近さで通る直線になっている。
重みは「なんとなく」決めるものではなく、各点を繰り返し測って見積もったばらつきから決めます。検量線ソフトでよく選べる 1/x や 1/x2 の重みは、それぞれ「分散が濃度に比例する」「分散が濃度の2乗に比例する(標準偏差が濃度に比例する)」という仮定に当たります(例題4の重みは実質 1/x2 です)。どちらを使うかで結果が変わるので、繰り返し測定や残差プロットで根拠を示してから使い、レポートにもその根拠を書きます。
対数をとって直線にするときの注意
一次反応の ln[A] 対 t や、アレニウスプロットの ln k 対 1/T のように、式を変形して直線にしてから最小二乗法を使う場面は多くあります(反応速度式と反応次数・アレニウスの式)。このとき、変換によって誤差の大きさも変わることに気をつけます。y の誤差が一定の大きさ s なら、ln y の誤差はおよそ s/y で、y が小さい点(反応の終盤、濃度が下がった点)ほど ln y の誤差は大きくなります。変換後のデータを重みなしで当てはめると、この誤差の大きい点を、精度の良い点と同じ重みで扱うことになります。終盤の点が直線から外れて見えても、すぐに「反応次数が違う」と決めつけず、まず誤差の大きさを考えるのが筋です。
Excel で計算する:SLOPE・INTERCEPT・RSQ・LINEST
ここまでの計算は、Excel のワークシート関数で確かめられます。グラフに近似曲線を引く手順や、6種類の近似曲線の選び方はExcel の近似曲線の記事にまとめたので、ここでは最小二乗法の式と関数の対応に絞ります。関数の構文は Microsoft の公式サポートの表記に合わせています。例題2のデータを、A2:A7 に濃度、B2:B7 に吸光度として入力した場合の値を並べます。
| 関数(構文) | この記事の式 | 例題2での値 |
|---|---|---|
| SLOPE(既知の y, 既知の x) | 傾き b1 = Sxy/Sxx | =SLOPE(B2:B7,A2:A7) → 0.099571 |
| INTERCEPT(既知の y, 既知の x) | 切片 b0 = y − b1x | =INTERCEPT(B2:B7,A2:A7) → 0.002238 |
| RSQ(既知の y, 既知の x) | R2(相関係数 r の2乗) | =RSQ(B2:B7,A2:A7) → 0.99986 |
| STEYX(既知の y, 既知の x) | 残差の標準偏差 sr | =STEYX(B2:B7,A2:A7) → 0.002430 |
| DEVSQ(数値1, …) | 偏差平方和 Sxx | =DEVSQ(A2:A7) → 17.5 |
| T.INV.2T(確率, 自由度) | 両側の t 値 | =T.INV.2T(0.05,4) → 2.776 |
どの関数もy を先、x を後に書きます。グラフの横軸・縦軸の順とは逆なので、入れ替えないように注意してください。入れ替えると、「x を y に回帰した直線」という別の直線の値が返ってきます(最初の節で見たとおり、傾きは一般に一致しません)。Microsoft の解説によると、範囲の中の文字列・論理値・空白セルは無視されますが、数値の 0 は計算に含まれます。測っていない点を 0 と入力すると、その 0 が測定値として使われてしまいます。
LINEST で標準誤差まで一度に出す
LINEST(既知の y, [既知の x], [定数], [補正]) の4番目の引数(補正)を TRUE にすると、5行2列の統計量が返ります。=LINEST(B2:B7,A2:A7,TRUE,TRUE) の結果と、この記事の記号の対応は次のとおりです。
| 行 | 1列目 | 2列目 |
|---|---|---|
| 1 | 傾き b1:0.099571 | 切片 b0:0.002238 |
| 2 | 傾きの標準誤差 sb1:0.000581 | 切片の標準誤差 sb0:0.001759 |
| 3 | 決定係数 R2:0.99986 | y の標準誤差 sr:0.002430 |
| 4 | F 値:29384 | 自由度 n − 2:4 |
| 5 | 回帰平方和 SSreg:0.17350 | 残差平方和 SSres:2.362 × 10⁻⁵ |
1つの値だけを取り出すには INDEX を組み合わせます。Microsoft の解説にある =INDEX(LINEST(既知の y,既知の x),1) で傾き、2 で切片が出ます。補正を TRUE にした配列なら、=INDEX(LINEST(B2:B7,A2:A7,TRUE,TRUE),2,1) で傾きの標準誤差(2行1列目)が取り出せます。これらを使えば、信頼区間と未知試料の濃度の不確かさもセルの式で計算できます。
傾きの95%信頼区間の半幅     =T.INV.2T(0.05,4)*INDEX(LINEST(B2:B7,A2:A7,TRUE,TRUE),2,1)      → 0.0016
未知試料の濃度(D2 に吸光度の平均 0.252)
                            =(D2-INTERCEPT(B2:B7,A2:A7))/SLOPE(B2:B7,A2:A7)                → 2.508
濃度の標準偏差(m = 3、n = 6)
  =STEYX(B2:B7,A2:A7)/SLOPE(B2:B7,A2:A7)
   *SQRT(1/3+1/6+(D2-AVERAGE(B2:B7))^2/(SLOPE(B2:B7,A2:A7)^2*DEVSQ(A2:A7)))                → 0.0173
なお、Microsoft の解説には、INTERCEPT・SLOPE と LINEST は計算のアルゴリズムが違うので、データが不定で共線性がある場合には結果が違うことがある、と書かれています。既知の y がすべて 0、既知の x がすべて 1 のとき、SLOPE・INTERCEPT は #DIV/0! を返し、LINEST は 0 を返す、という例が挙がっています。ふつうの検量線のデータでは両者は一致します。
LINEST には重みを指定する引数がありません。重み付き最小二乗法を Excel で行うには、各行の y・1・x にそれぞれ √wi を掛けた列を作り、左に「√w の列」、右に「√w × x の列」を並べた2列を既知の x、「√w × y」を既知の y として、定数を FALSE にして LINEST を使う方法があります。√wi を掛けた残差の2乗の和は、wi を掛けた残差平方和 Sw そのものだからです(例題4のデータで、この方法が重み付きの公式と同じ b1 = 0.04991、b0 = 0.00057 を与えることを Python で確かめています)。LINEST は x の列が複数あるとき係数を右の列から順に返す({mn, …, m1, b})ので、1つ目に返る値が「√w × x の列」の係数=傾きです。
よくある間違い
もう1つ、レポートで目立つのが傾きと切片の桁です。Excel が返す 0.0995714285… をそのまま書くのではなく、標準誤差に合わせて丸めます。例題2なら傾きの標準誤差が 0.00058 なので、傾きは小数第4位まで、0.0996 ± 0.0006(標準誤差)または 0.0996 ± 0.0016(95% 信頼区間)と書くのが適切です。どちらの ± なのかも必ず明記します。桁の決め方の一般論は有効数字の記事、グラフと表の体裁はレポートの表・グラフの書き方を参照してください。
試験での問われ方
大学の分析化学・物理化学実験の試験や院試では、最小二乗法は次のような形で出題されます。
- 公式の導出:残差平方和を b0・b1 で偏微分し、正規方程式から傾きと切片を導く。「なぜ2乗の和を最小にするのか」の説明を添えると強い
- 手計算:5点前後のデータから Σx・Σy・Σx2・Σxy を作って傾きと切片を出す(例題1)
- 性質の証明:回帰直線が重心を通ること、残差の和が 0 になることを示す
- 誤差と信頼区間:sr を n − 2 で割る理由、傾きの信頼区間、検量線で読んだ濃度の不確かさが重心で最小になる理由(例題2)
- R2 の解釈:R2 が1に近くても直線とは限らない理由、残差プロットの読み方(例題3・図3)
- 応用:一次反応の ln[A] 対 t、アレニウスプロットの傾きから速度定数や活性化エネルギーを求める
まとめ
最小二乗法の公式は、「縦のずれの2乗の和を最小にする」という1つの約束を微分しただけのものでした。その約束から、直線が重心を通ること、n − 2 で割る理由、x を広く散らすと傾きが確かになる理由、検量線の真ん中で読むべき理由までが、すべて同じ筋で出てきます。Excel が出す数字の1つ1つが、どの式のどの部分なのかを説明できれば、レポートの考察で数値の信頼性を自分の言葉で語れるようになります。
よくある質問
最小二乗法は、測定点と当てはめる直線(または曲線)との縦のずれである残差を2乗して足した値が最も小さくなるように、式の係数を決める方法です。直線 y = b0 + b1x なら、傾きは b1 = Σ(x − x)(y − y)/Σ(x − x)2、切片は b0 = y − b1x で求まります(上線付きの x・y はそれぞれの平均)。Excel の近似曲線や SLOPE・INTERCEPT 関数もこの方法で計算しています。
残差平方和 S = Σ(yi − b0 − b1xi)2 を切片 b0 と傾き b1 でそれぞれ偏微分して 0 とおきます。すると nb0 + (Σxi)b1 = Σyi と (Σxi)b0 + (Σxi2)b1 = Σxiyi という正規方程式が得られ、これを解くと b1 = (nΣxiyi − ΣxiΣyi)/(nΣxi2 − (Σxi)2)、b0 = (Σyi − b1Σxi)/n になります。S は係数の2次式で下に凸なので、この点が最小です。
残差をそのまま足すと正と負が打ち消し合い、最小二乗法の直線では和がちょうど0になるので、合い具合の物差しになりません。2乗すると符号が消え、しかも係数について微分できるので、傾きと切片が公式として1組に決まります。絶対値の和を最小にする方法もありますが、微分できない点があって解析的に解けず、解が1つに決まらない場合もあります。また、各点の誤差が同じ大きさの正規分布に従い互いに独立なとき、最小二乗法の直線は最も確からしい直線(最尤推定)になります。
直線の傾きと切片の2つをデータから決めているからです。最小二乗法の残差は、残差の和が0、残差と x の積の和が0という2つの条件を必ず満たすので、n 個の残差のうち自由に動けるのは n − 2 個だけです。直線はデータに寄せて引かれているぶん残差は小さめに出るので、n で割るとばらつきを過小評価します。自由度 n − 2 で割るとこの偏りが補正されます。点が2個なら自由度は0で、ばらつきは見積もれません。
言えません。R2 は y のばらつきのうち直線で説明できた割合で、データが曲がっていても、外れ値が1つあっても高い値になることがあります。また、濃度の範囲を広げるだけで R2 は1に近づき、点の数が少ないと R2 が高くても傾きの信頼区間は広くなります。直線かどうかは残差プロットで規則的な並びが無いかを見て判断し、傾きは標準誤差(または信頼区間)と点の数を添えて報告します。
関連記事
検量線の3つの方法(絶対検量線法・内部標準法・標準添加法)の使い分けは検量線の記事、Excel のグラフ操作と近似曲線の種類はExcel の近似曲線の記事にまとめています。
- Excel(エクセル)の近似曲線|6種類の選び方・数式とR2乗値・検量線の例
- 検量線とは?絶対検量線法・内部標準法・標準添加法の違いと使い分け
- ランベルト・ベールの法則とは?吸光度・透過率・モル吸光係数の求め方
- 検出限界と定量限界の違いと求め方|S/N比・3.3σ/S・分析法バリデーション
- 標準偏差と標準誤差の違いとは?n-1で割る理由・相対標準偏差と変動係数
- t検定のやり方とp値の意味|対応のある・ないの使い分けとExcelのT.TEST
- 誤差の伝播とは?不確かさの計算式と合成標準不確かさ・滴定の計算例
- レポートの表・グラフの書き方|表題の位置・軸の単位・有効数字・誤差棒
参考文献:D. Harvey, Analytical Chemistry 2.1, §5.4 Linear Regression and Calibration Curves(LibreTexts)。F. J. Anscombe, "Graphs in Statistical Analysis", The American Statistician 1973, 27(1), 17–21。Microsoft サポート「SLOPE 関数」「INTERCEPT 関数」「RSQ 関数」「LINEST 関数」「STEYX 関数」「T.INV.2T 関数」「DEVSQ 関数」。