分散分析とは?一元配置のやり方と分散分析表の読み方|F値・p値とExcel
同じ試料の鉄の濃度を、3つの試験室がそれぞれ5回ずつ測りました。平均は 10.30、10.70、10.50 mg/L。この違いは試験室の差でしょうか、それとも測定のたびに出るばらつきが、たまたま平均にも出ただけでしょうか。2つなら t 検定で比べられます。では3つなら、A と B、A と C、B と C の3回 t 検定をすればよいのでしょうか。
答えは「いいえ」です。3回検定すると、本当はどこにも差が無くても、どれか1つが偶然「有意」になる確率が 5% を大きく超えてしまいます。3つ以上の平均を1回の検定で比べる方法が、分散分析(analysis of variance、ANOVA)です。
「平均を比べるのに、なぜ分散を分析するのか」が腑に落ちると、分散分析表のどの数字が何を意味するのか、Excel の出力のどこを見ればよいのかが一度に見えてきます。この記事では、同じデータで分散分析表を手計算で作り、Excel の分析ツールの出力と1つずつ突き合わせます。そのうえで、どの群が違うのかを調べる多重比較と、分析法の精度を「試験室の中」と「試験室の間」に分ける使い方までつなげます。t 値と p 値の基本はt 検定の記事で扱っているので、ここでは「3つ以上を比べる」ことに集中します。
なぜ t 検定を繰り返してはいけないのか
有意水準 5% の t 検定は、「本当は差が無いのに差があると言ってしまう誤り(第一種の誤り)」を、1回の検定あたり 5% に抑える約束です。ところが検定を何回も行えば、そのうちどれか1つで誤る確率は 5% より大きくなります。くじを1回引いて当たる確率は 5% でも、何回も引けば一度は当たりやすくなるのと同じです。
群の数を k とすると、2つずつの組み合わせは k(k − 1)/2 通りあります。各検定が互いに独立だと仮定すると、どれか1つでも誤る確率は 1 − 0.95m(m は検定の回数)です。実際には同じ群が何度も使われるので検定どうしは独立ではなく、正確な値は数値計算かシミュレーションで求めます。そこで、全群の母平均が等しい正規分布から各群5個のデータを作り、全部の組に t 検定をする実験を 200,000 回繰り返しました。
| 群の数 k | 組の数 | 独立と仮定した概算 | シミュレーション(t 検定の繰り返し) | 分散分析・Tukey の方法 |
|---|---|---|---|---|
| 3 | 3 | 14.3% | 12.3% | 約 5% |
| 4 | 6 | 26.5% | 20.5% | 約 5% |
| 5 | 10 | 40.1% | 28.9% | 約 5% |
| 6 | 15 | 53.7% | 36.9% | 約 5% |
3群でも 12.3%、6群なら 36.9% です。概算より小さいのは、同じ群が複数の検定に入るので「1つの群がたまたま外れると、その群を含む検定がそろって有意になる」という形で誤りが重なり、独立なときほどばらけないからです。それでも 5% の約束は大きく破れています。6種類の触媒や6つのロットを総当たりで t 検定にかけると、どれも本当は同じでも、3回に1回以上「どこかに差がある」と報告してしまう計算です。
一方、分散分析の F 検定と Tukey の方法(後で扱う多重比較)は、同じシミュレーションで群の数によらず約 5%(4.9〜5.1%)になりました。「全体として 5%」を守るように作られているのがこの2つです。Harvey の分析化学の教科書も、t 検定はそれぞれが確率 α で誤って有意とするので、まず分散分析で全体を調べる、と説明しています。
分散分析の考え方:平均の差を「ばらつきの比」で見る
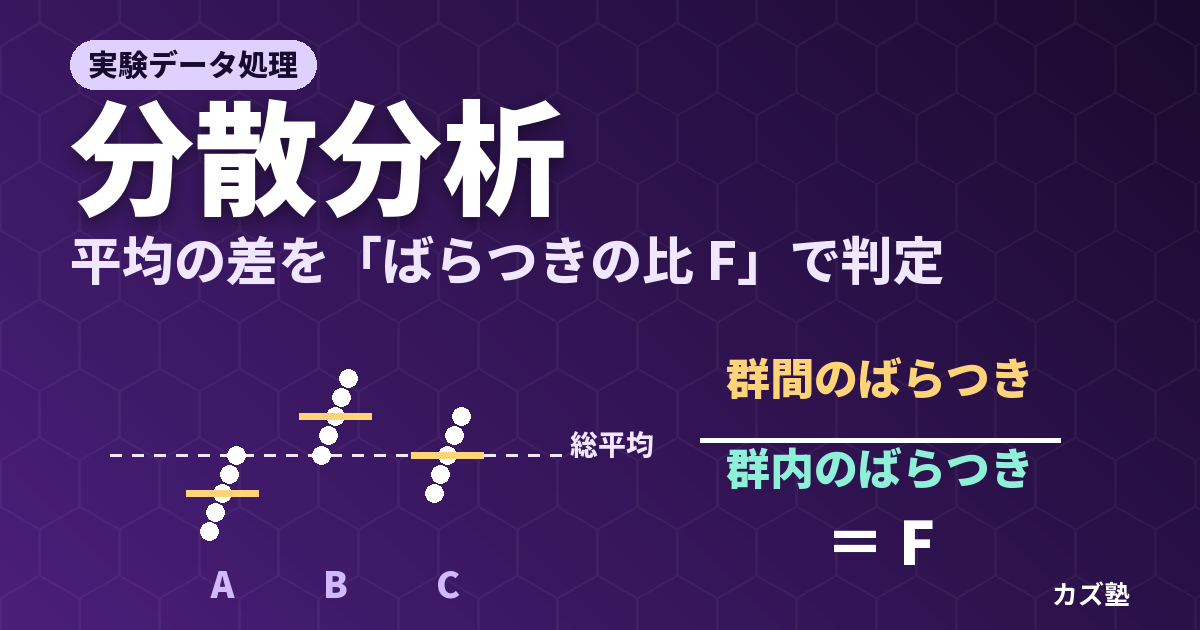
分散分析の名前に「分散」が入っているのは、平均の差を直接は計算せず、2種類のばらつきを比べることで平均の差を判定するからです。ここに分散分析のいちばん大事な理屈があります。
まず記号を決めます。群の数を k、群 i のデータ数を ni、全部のデータ数を N、群 i の j 番目の測定値を xij、群 i の平均を mi、全データの平均(総平均)を m とします(平均を m、n − 1 で割って求めた標準偏差を s と書くのは、t 検定の記事と同じです)。
群内のばらつき:1回の測定の揺れ
同じ試験室の5回の測定値がばらつくのは、測定そのものの揺れ(偶然誤差)だけが原因です。試験室の違いは入りません。だから、各群の中のばらつきをまとめると、測定の揺れの大きさ σ2 の推定値になります。これは t 検定で2群の分散を合算したのと同じ考え方を、3群以上に広げたものです。
群間のばらつき:平均どうしの散らばり
次に、群の平均 m1、m2、m3 の散らばりを考えます。もし試験室に本当の差が無ければ、平均が散らばる原因も測定の揺れだけです。標準偏差と標準誤差の記事で見たとおり、n 個の平均の揺れ(分散)は σ2/n に縮みます。逆に言えば、平均どうしの分散に n を掛ければ、もう一度 σ2 の推定値になるはずです。
こうして、測定の揺れ σ2 を2通りに見積もれます。群内から見積もった値と、群間(平均の散らばり × n)から見積もった値です。差が無ければ、2つはだいたい同じ大きさになり、比はおよそ 1 です。試験室に本当の差があると、平均の散らばりに「試験室の差」が上乗せされるので、群間から見積もった値だけが大きくなります。この比が F 値です。
F = 群間の平均平方 MSB / 群内の平均平方 MSW

差が無いとき:  MSB も MSW も σ2 を推定する      → F はおよそ 1
差があるとき:  MSB だけ「群の差」の分だけ大きくなる  → F は 1 より大きくなる
F が大きいほど「平均の散らばりは測定の揺れだけでは説明しにくい」ことになります。F が 1 より小さいことは差の証拠にならないので、判定は右側(F が大きい側)だけの片側で行います。Harvey の教科書も F 検定をこの片側の形で使っています。
平方和の分解:総平方和=群間平方和+群内平方和
2種類のばらつきを数にするのが平方和(sum of squares、SS)です。各測定値の総平均からのずれ(総偏差)は、次のように2つに分けられます。
xij − m  =  (mi − m)  +  (xij − mi)
総偏差       群間の偏差     群内の偏差
これを2乗してすべてのデータについて足すと、次の関係が成り立ちます。
SST = ΣiΣj (xij − m)2            総平方和     自由度 N − 1
SSB = Σi ni (mi − m)2             群間平方和   自由度 ν1 = k − 1
SSW = ΣiΣj (xij − mi)2           群内平方和   自由度 ν2 = N − k

SST = SSB + SSW        N − 1 = (k − 1) + (N − k)
2乗の和なのに単純に足し算で分かれるのは、2乗を展開したときに出る交差項 2(mi − m)(xij − mi) の合計が 0 になるからです。群 i の中では (mi − m) は共通の定数なので外に出せて、残る Σj(xij − mi) は「群の平均からの偏差の和」なので必ず 0 です。平均からの偏差の和が 0 になることは、標準偏差を n − 1 で割る理由と同じ性質です。検量線の回帰でも、総平方和を「直線で説明できる部分」と「残差」に分ける同じ形の分解が使われ、決定係数 R2 はその比として定義されます(最小二乗法の記事)。
自由度も同じ理屈で分かれます。群内では、群ごとに平均を1つずつ決めるので、N 個から k 個減って N − k。群間では k 個の群の平均が総平均のまわりで散らばり、その偏差(データ数で重みをつけた和)が 0 になる制約が1つあるので k − 1 です。平方和を自由度で割ったものが平均平方(mean square、MS)で、これが先ほどの「σ2 の2通りの推定値」に当たります。
MSB = SSB / (k − 1) MSW = SSW / (N − k) F = MSB / MSW(自由度 ν1, ν2 の F 分布で判定)
群のデータ数がそろっている(どれも n)とき、MSB = n × Σ(mi − m)2/(k − 1) は、まさに「平均どうしの分散 × n」です。MSW は各群の分散 si2 の平均で、t 検定の合算分散を3群以上に広げたものになっています。
分散分析表の作り方(例題1:3つの試験室の分析値)
例題1:同じ試料溶液の鉄の濃度を、3つの試験室 A・B・C がそれぞれ5回ずつ測定した(原子吸光分析などを想定した、計算練習用の仮の値。単位 mg/L)。試験室の間で平均に差があるといえるか。有意水準 5% で判定せよ。
| 試験室 | 測定値(mg/L) | 平均 mi | 分散 si2 |
|---|---|---|---|
| A | 10.2, 10.4, 10.1, 10.3, 10.5 | 10.30 | 0.025 |
| B | 10.6, 10.9, 10.5, 10.8, 10.7 | 10.70 | 0.025 |
| C | 10.6, 10.2, 10.5, 10.8, 10.4 | 10.50 | 0.050 |
手順は「平均を出す → 平方和を2つ出す → 自由度で割る → 比をとる」の4段階です。
(1)平均   mA = 10.30   mB = 10.70   mC = 10.50   総平均 m = 10.50(k = 3、n = 5、N = 15)

(2)群内平方和:各群の平均からの偏差の2乗和
     A:−0.1, +0.1, −0.2, 0, +0.2   → 0.10
     B:−0.1, +0.2, −0.2, +0.1, 0   → 0.10
     C:+0.1, −0.3, 0, +0.3, −0.1   → 0.20      SSW = 0.40
     群間平方和:SSB = 5 × [(−0.2)2 + (+0.2)2 + 02] = 5 × 0.08 = 0.40
     確かめ:総平方和 SST = 0.30 + 0.30 + 0.20 = 0.80 = 0.40 + 0.40

(3)平均平方  MSB = 0.40 / 2 = 0.200     MSW = 0.40 / 12 = 0.0333

(4)F = 0.200 / 0.0333 = 6.00   自由度 (2, 12)
     5% の臨界値 F0.05(2, 12) = 3.885   p = 0.0156
F = 6.00 は臨界値 3.885 を超えるので、「3つの試験室の母平均はすべて等しい」という帰無仮説を棄却します。p = 0.0156 は「母平均がすべて等しいとしたら、F が 6.00 以上になる確率」です(1% の臨界値 6.927 には届かないので、1% 水準では有意ではありません)。
群間平方和のところは、「平均どうしの分散 × n」で検算できます。3つの平均 10.30、10.70、10.50 の分散(k − 1 = 2 で割る)は 0.04 で、5 を掛けると MSB = 0.200 になります。もし差が無ければ、平均の分散は σ2/5 ≈ 0.0333/5 = 0.0067 程度のはずなので、実際の 0.04 はその6倍です。F = 6 の意味はこれです。
測定値から共通の数(ここでは 10)を引いても、平方和は変わりません(偏差は引いた数によらないため)。0.2、0.4、… のように小さな数にしてから計算すると、桁を取り違えにくくなります。
分子の自由度が 2 のときに限り、F 分布の右側の確率は (1 + 2F/ν2)−ν2/2 という簡単な式で表せます。例題1では (1 + 2 × 6/12)−6 = 2−6 = 1/64 = 0.015625 で、Excel の F.DIST.RT(6, 2, 12) の値と一致します。
分散分析表にまとめる
計算の結果は、次の形の分散分析表にまとめます。行が「ばらつきの原因(変動要因)」、列が「平方和 → 自由度 → 平均平方 → F → p」の計算の順番です。左から右へ読めば、計算の手順そのものになっています。
| 変動要因 | 平方和 SS | 自由度 | 平均平方 MS | F | p |
|---|---|---|---|---|---|
| 群間(試験室) | 0.40 | 2 | 0.200 | 6.00 | 0.0156 |
| 群内(誤差) | 0.40 | 12 | 0.0333 | ||
| 合計 | 0.80 | 14 |
表の読み方のコツは3つです。第一に、平方和と自由度は縦に足すと合計になる(0.40 + 0.40 = 0.80、2 + 12 = 14)。合わなければ計算のどこかが間違っています。第二に、平均平方は縦に足さない。平方和を自由度で割った「1自由度あたりのばらつき」なので、合計の行には書きません。第三に、F は群間の平均平方を群内の平均平方で割ったもので、群内の行が分母の役をします。群内の行を「誤差」や「残差」と書く教科書が多いのは、この行が「群の違いでは説明できない、測定の揺れ」を表すからです。
結論の書き方:「どこかに差がある」までしか言えない
分散分析で有意になったときに言えるのは、「3つの母平均がすべて等しいとはいえない(少なくとも1つは違う)」までです。どの試験室が違うのか、A と B なのか、B だけが外れているのかは、分散分析表からはわかりません。それを調べるのが後の節の多重比較です。
3試験室の測定値について一元配置分散分析を行った結果、試験室の効果は有意であった(F(2, 12) = 6.00、p = 0.016)。どの試験室間に差があるかを Tukey の方法で調べたところ、試験室 B の平均は試験室 A より 0.40 mg/L 高かった(95% 同時信頼区間 0.09〜0.71 mg/L、調整済み p = 0.012)。A と C、B と C の差は有意とはいえなかった。
逆に有意でなかったときは、「試験室の間に有意な差があるとはいえない」と書きます。t 検定のときと同じく、これは「差が無い」ことの証明ではありません(t 検定の記事の「p 値の正しい意味」)。
分散分析の前提:独立・正規性・等分散
F が F 分布に従うという計算は、次の3つの前提の上に成り立っています。
- 独立性:各測定値が互いに独立に得られていること。破れたときの影響が大きい前提です
- 正規性:各群の測定値(正確には、群の平均からの偏差)が正規分布に従うこと
- 等分散:どの群も母分散が等しいこと。MSW は各群の分散を合算した値なので、この前提が無いと「1つの σ2」を推定したことにならない
独立性:何を「繰り返した」のかを確かめる
化学の実験で多いのは、同じ溶液を装置に5回注入した値を「5回の測定」として扱う失敗です。これは注入と検出の揺れしか含まず、試料の調製や前処理の揺れは入っていません。そのため群内のばらつき MSW が小さく見積もられ、F が過大になります。試験室の差を調べたいなら、群内の繰り返しは「試料の調製からやり直した独立な5回」でなければなりません。何を繰り返したかで、MSW が表すばらつきの中身が決まります。
正規性と等分散:崩れたときの影響
正規性については、各群のデータ数がそろっていれば、分布が多少歪んでいても F 検定の結果は大きくは狂わないことが、Glass・Peckham・Sanders(1972)の総説などでまとめられています。データが少ないと正規性そのものを確かめるのが難しいので、まず点を並べた図で、極端な外れ値や偏りが無いかを目で確かめます。外れ値の扱いは外れ値の検定(グラブス検定とQ検定)の記事で扱います。
注意が要るのは等分散のほうです。2群の場合、分散分析の F は Student の t 検定(等分散を仮定する t 検定)の t の2乗にちょうど一致し、p 値も同じになります。実際、t 検定の記事の例題3(実験者 X が8回でばらつき小、Y が4回でばらつき大、分散の比は約57倍)を分散分析にかけると、F = 8.71(= 2.952)、p = 0.0145 で、Student の t 検定とまったく同じ結果になります。等分散を仮定しない Welch の t 検定では p = 0.136 でした。つまり分散分析は、Student の t 検定と同じ弱点、データ数の少ない群のばらつきが大きいと差を過大に評価しやすい、という性質を持っています。
データ数をそろえれば、分散の違いの影響は小さくなります。Box(1954)は、群のデータ数が等しいときは分散の違いが F 検定に与える影響は比較的小さく、データ数が違うとずれがずっと大きくなることを示しました。ただし影響が無くなるわけではありません。全群の母平均が等しい正規分布から 3 群のデータを作って 200,000 回検定すると、各群5個でも、標準偏差の比が 1:1:3 なら「有意」と誤る確率は 8.4%、1:1:5 なら 10.2% になりました。データ数が 8・8・4 で、4個の群の標準偏差が3倍だと 18.6% です。
群の分散が大きく違うときは、等分散を仮定しない Welch の分散分析(Welch, 1951)を使います。同じシミュレーションでは、Welch の分散分析の誤りの確率は 5.1%(各群5個・1:1:3)、5.2%(1:1:5)、5.9%(8・8・4・1:1:3)で、5% に近く保たれました。例題1のデータに Welch の分散分析を使うと p = 0.016 で、ふつうの分散分析(p = 0.0156)とほとんど変わりません(各群の分散の比が最大でも2倍で、データ数もそろっているため)。正規性が疑わしいときの順位に基づく方法として Kruskal–Wallis 検定もあります。どれを使うかは、F検定の記事で扱う「先に等分散の検定をして機械的に切り替える」やり方の問題も含めて、データを見る前に実験の計画の段階で決めておくのが筋です。
どの群が違うのか:多重比較(Tukey と Bonferroni)
分散分析で「どこかに差がある」とわかったら、次はどの組に差があるかを調べます。ここで補正なしの t 検定を3回やると、最初の節の問題に逆戻りします。そこで、全部の比較をひとまとめにして、どれか1つで誤る確率を 5% に抑えるように臨界値を大きくした方法を使います。これが多重比較です。NIST/SEMATECH の統計ハンドブックは、補正しない対ごとの比較を繰り返すと全体の有意水準が保たれないとしたうえで、すべての対を比べる Tukey の方法と、前もって選んだいくつかの比較に使う Bonferroni の方法などを挙げています。
Tukey の方法(すべての対を比べる)
Tukey の方法(Tukey が考案した方法で、HSD〔honestly significant difference〕法とも呼ばれる)は、群の平均の中でいちばん大きいものといちばん小さいものの差が、偶然でどこまで開きうるかを基準にします。全部の対の中で最も開くのは最大と最小の対なので、その差の分布(スチューデント化された範囲 q の分布)で臨界値を決めておけば、どの対についても「偶然を差と見誤る」確率を全体で 5% に抑えられる、という理屈です。各群のデータ数が n でそろっているとき、2つの平均の差がこれより大きければ有意とします。
臨界差(HSD) = q0.05(k, ν2) × √(MSW / n)

例題1:q0.05(3, 12) = 3.773    √(0.0333 / 5) = 0.0816
       HSD = 3.773 × 0.0816 = 0.308 mg/L

B − A = 0.40 > 0.308  → 有意(調整済み p = 0.012、95% 同時信頼区間 0.09〜0.71)
C − A = 0.20 < 0.308  → 有意とはいえない(p = 0.23、−0.11〜0.51)
B − C = 0.20 < 0.308  → 有意とはいえない(p = 0.23、−0.11〜0.51)
分母の MSW には、比べる2群だけでなく全部の群から合算した群内の平均平方を使います。自由度が 12 と大きくなる分、2群だけで分散を出すより推定が安定します。群のデータ数がそろっていないときは、√(MSW/n) の代わりに √[MSW/2 × (1/ni + 1/nj)] を使う Tukey–Kramer の方法(Kramer, 1956)にします。
Bonferroni の方法(比べる数で有意水準を割る)
Bonferroni の方法は、比較の回数を m として、1回ごとの有意水準を α/m に厳しくするだけの単純な方法です。どれか1つで誤る確率は、各検定の誤る確率の和(α/m × m = α)を超えないので、検定どうしがどう関係していても全体を α 以下に抑えられます。p 値で言えば、補正なしの p を m 倍して 0.05 と比べるのと同じです。
例題1(m = 3):1回ごとの α = 0.05 / 3 = 0.0167
  t の臨界値 t(1 − 0.0167/2, 12) = 2.779    差の標準誤差 √(2 × 0.0333 / 5) = 0.1155
  臨界差 = 2.779 × 0.1155 = 0.321 mg/L
  B − A:t = 3.46、補正なし p = 0.0047 → ×3 = 0.014(有意)
  C − A、B − C:t = 1.73、補正なし p = 0.109 → ×3 = 0.33(有意とはいえない)
図3のように、区間の半幅は補正なし 0.252、Tukey 0.308、Bonferroni 0.321 の順に広がります。ここでの「補正なし」は、3群全部から求めた MSW(自由度 12)を使い、臨界値だけを1回の t 検定の t(0.975, 12) = 2.179 にしたものです(2群だけのデータで t 検定をすると、B − A では自由度 8 で半幅 0.231 になり、これとも少し違います)。補正なしの区間が狭いのは、「3つを同時に見る」ことを考えていないからです。この例では、どの方法でも B と A の差だけが有意で、結論は変わりません。
Tukey と Bonferroni の使い分け
全部の対を比べるなら Tukey、前もって決めた少数の比較だけなら Bonferroni、が基本です。全部の対を比べる場合、Bonferroni は Tukey より少し保守的(臨界差が大きい)になります。各群5個のデータで計算すると、群が 3〜8 のとき、Bonferroni の臨界差は Tukey より約4〜5%(4.2〜5.4%)大きくなりました。一方、「新しい前処理法を、従来法と比べる」のように比べたい組が初めから少数に決まっているなら、全部の対を対象にする Tukey より、その数だけで割る Bonferroni のほうが臨界差が小さく、差を見つけやすくなります。1つの対照群と残りの群を比べる専用の方法として Dunnett の方法もあります。
もう1つ知っておきたいのは、分散分析の結果と多重比較の結果は、必ずしもそろわないことです。GraphPad の統計の手引きは、Tukey などの多重比較は全体の分散分析が有意でなくても有効であること(例外は、分散分析が有意なときだけ t 検定をする制限付きの Fisher の LSD で、これは今は勧められない。Scheffé の方法は全体の F 検定と結びついていて、F が有意でなければどの比較も有意にならない)、逆に分散分析が有意でも、どの対も有意にならないことがありうることを説明しています。分散分析は「全体として差があるか」、多重比較は「どの対に差があるか」という別の問いに答えているからです。
Excel の分析ツールには多重比較の機能がありません。Tukey の q の臨界値は数表か統計ソフトで求めます。Python なら scipy.stats.tukey_hsd、R なら TukeyHSD 関数で、差・同時信頼区間・調整済み p 値がまとめて出ます(Harvey の教科書は R の TukeyHSD の使い方を例で示しています)。
精度を分ける:併行精度と室間再現精度
ここまでは「試験室の間に差があるか」を検定してきました。分析化学では、同じ分散分析表をばらつきの大きさを見積もる道具として使う場面のほうが多いかもしれません。新しい分析法を標準法にするとき、「同じ試験室で繰り返したときのばらつき」と「試験室が変わったときのばらつき」をそれぞれ数字で示す必要があるからです。
検出限界と定量限界の記事の分析法バリデーションの節で見たように、精度には3段階があります。同じ条件で短時間に繰り返したときの併行精度(repeatability)、同じ施設で日・人・装置を変えたときの室内再現精度(intermediate precision)、異なる施設の間の室間再現精度(reproducibility)です。測定方法の精度を共同実験で求める規格 ISO 5725-2(日本では JIS Z 8402-2「標準測定方法の併行精度及び再現精度を求めるための基本的方法」が対応)は、併行精度と再現精度(=室間再現精度)を扱う規格です。
群内と群間を「ばらつきの成分」として読む
各試験室の測定値を「真の値 + その試験室に固有のずれ + 1回ごとの揺れ」と考えます。試験室に固有のずれの分散を σL2、1回ごとの揺れの分散を σr2 とすると、群内の平均平方は揺れだけを含むので σr2 を推定します。群間の平均平方には、平均の揺れ(σr2/n)に試験室のずれ(σL2)が上乗せされたものに n を掛けた量、つまり σr2 + nσL2 が対応します。Harvey の教科書も、共同試験の分散分析について、群間の分散が「偶然誤差の分散 + 繰り返し数 × 分析者ごとの系統誤差の分散」になることを示しています。これを逆に解くと、各成分が求まります。
併行分散       sr2 = MSW(併行標準偏差 sr = √MSW)
室間の分散成分 sL2 = (MSB − MSW) / n      (負になったら 0 とする)
再現分散       sR2 = sr2 + sL2(再現標準偏差 sR はその平方根)
(各試験室の繰り返し数 n がそろっている場合)
例題2:例題1のデータを、ある分析法の共同実験の結果とみなして、併行標準偏差 sr と再現標準偏差 sR を求めよ。
sr2 = MSW = 0.0333 より sr = 0.183 mg/L(相対標準偏差 1.74%)。sL2 = (0.200 − 0.0333)/5 = 0.0333 より sL = 0.183 mg/L。sR2 = 0.0333 + 0.0333 = 0.0667 より sR = 0.258 mg/L(相対標準偏差 2.46%)。この例ではたまたま試験室の成分と1回ごとの揺れが同じ大きさなので、sR は sr の √2 倍になった。
ここで、15個のデータを全部まとめて1つの標準偏差を計算すると 0.239 mg/L になります。これは sr(0.183)とも sR(0.258)とも違う、2種類のばらつきが混ざった、どちらとも言えない値です。「同じ試験室でもう一度測ったらどれくらい揺れるか」と「別の試験室で測ったらどれくらい揺れるか」は別の問いで、分散分析で分けて初めて両方に答えられます。
室間再現精度は、併行精度より必ず大きいか等しくなります(sL2 ≥ 0 を足すため)。MSB が MSW より小さく sL2 が負に出るのは、試験室の差がばらつきに埋もれて見えないことを意味し、0 として扱います。また、3つの試験室から求めた sL は、たった3つの平均から推定した値なので、それ自体がきわめて不確かです。実際の共同実験はもっと多くの試験室で行います。同じ計算は、試験室を「試験日」に置き換えれば、1つの施設の中の室内再現精度にも使えます。
「試験室」の扱いには2つの見方があることにも触れておきます。例題1のように「この3つの試験室に差があるか」を知りたいときは、試験室そのものに興味がある(母数効果)見方で、例題2のように「試験室が変わるとどれだけ揺れるか」を知りたいときは、試験室を多くの試験室の代表として扱う(変量効果)見方です。一元配置では F の計算は同じですが、知りたいことが違うので、結果の書き方が変わります。求めた sR を不確かさの見積もりに使う方法は、誤差の伝播の記事の合成標準不確かさの考え方につながります。
二元配置と交互作用(要点)
原因が2つあるときは二元配置の分散分析を使います。たとえば、試料の分解法(2種類)と試料の種類(3種類)の組み合わせごとに添加回収試験を3回ずつ行い、回収率を比べる場合です。二元配置では、総平方和が「原因 A」「原因 B」「交互作用」「誤差」の4つに分かれます。
交互作用とは、一方の原因の効果が、もう一方の水準によって変わることです。次の例題3(仮の値)で見ます。
| 回収率の平均(%) | 土壌 | 植物 | 底質 |
|---|---|---|---|
| マイクロ波分解(98.5, 99.2, 98.8 / 99.0, 98.4, 99.3 / 98.7, 99.1, 98.6) | 98.83 | 98.90 | 98.80 |
| ホットプレート分解(98.2, 98.9, 98.4 / 94.1, 95.0, 94.4 / 98.0, 98.6, 98.3) | 98.50 | 94.50 | 98.30 |
| 変動要因 | 平方和 | 自由度 | 平均平方 | F | 5% の臨界値 |
|---|---|---|---|---|---|
| 分解法 | 13.69 | 1 | 13.69 | 98.6 | 4.747 |
| 試料の種類 | 14.61 | 2 | 7.30 | 52.6 | 3.885 |
| 交互作用 | 15.89 | 2 | 7.94 | 57.2 | 3.885 |
| 誤差(繰り返し) | 1.67 | 12 | 0.139 | ||
| 合計 | 45.86 | 17 |
3つの F はどれも臨界値を大きく超えています(p はどれも 10−5 未満)。ここで「分解法の効果が有意だから、マイクロ波分解のほうが回収率が高い」と読むのは早すぎます。2つの分解法の差は、土壌で 0.33、底質で 0.50 ポイントなのに、植物では 4.40 ポイントもあります。差のほとんどは植物試料で生じていて、交互作用が有意なときは、主効果(分解法だけ・試料だけの効果)を単独で解釈するのは慎重にしなければなりません。この例なら、「ホットプレート分解は、植物試料でだけ回収率が下がる」と組み合わせで述べ、植物試料の何が分解を難しくしているのかを化学の側から考えることになります。
交互作用を誤差と分けて取り出せるのは、同じ組み合わせを繰り返し測っているからです。各組み合わせで1回しか測らない「繰り返しのない二元配置」では、交互作用と測定の揺れを区別できず、両者が誤差の行にまとめて入ります。交互作用がありそうな実験では、各組み合わせを少なくとも2回以上測る計画にします。
Excel で分散分析をする:分析ツールの出力の読み方
Excel では、分析ツール(アドイン)の「分散分析: 一元配置」で分散分析表が作れます。分析ツールは最初は無効なので、Windows 版では [ファイル] → [オプション] → [アドイン] で、[管理] ボックスの [Excel アドイン] を選んで [設定] を押し、[分析ツール] にチェックを入れます。有効にすると [データ] タブに [データ分析] が現れます。
データは、試験室ごとに1列にして(A 列に試験室 A の5個、B 列に B の5個…)、先頭の行に試験室の名前を入れておきます。[データ分析] で「分散分析: 一元配置」を選び、入力範囲に見出しを含めた範囲を指定し、データが列ごとに並んでいること、先頭行がラベルであること、α = 0.05 を指定して出力先を選びます。例題1をこの手順で計算すると、Excel(バージョン 16.0)は「概要」と「分散分析表」の2つの表を出しました。
概要
グループ  データの個数  合計   平均   分散
試験室A        5         51.5   10.3   0.025
試験室B        5         53.5   10.7   0.025
試験室C        5         52.5   10.5   0.05

分散分析表
変動要因    変動   自由度   分散       観測された分散比   P-値       F 境界値
グループ間   0.4     2      0.2          6                 0.015625   3.885294
グループ内   0.4    12      0.033333
合計         0.8    14
Excel の列の名前は、教科書の用語と違うので読み替えが必要です。
| Excel の表示 | 統計の用語 | 中身 |
|---|---|---|
| グループ間・グループ内 | 群間・群内(誤差) | ばらつきの原因 |
| 変動 | 平方和 SS | 偏差の2乗和。縦に足すと合計になる |
| 分散(分散分析表の中) | 平均平方 MS | 変動 ÷ 自由度。各群の分散ではない |
| 観測された分散比 | F 値 | グループ間の分散 ÷ グループ内の分散 |
| P-値 | p 値 | F 分布で観測した F より右側の確率。=F.DIST.RT(F, 自由度1, 自由度2) と同じ |
| F 境界値 | 臨界値 | 指定した α の F。=F.INV.RT(α, 自由度1, 自由度2) と同じ |
いちばん紛らわしいのは「分散」です。上の「概要」の表の「分散」は各群の分散(n − 1 で割った標本分散。試験室A の 0.025)ですが、下の「分散分析表」の「分散」は平均平方です。グループ内の「分散」0.033333 は、各群の分散 0.025、0.025、0.05 の平均になっていることを確かめてみてください(データ数がそろっているときに成り立つ関係)。
判定は、「観測された分散比」が「F 境界値」より大きいか、または「P-値」が α より小さいかで行います。2つは同じことを別の側から見ています。数表なしで臨界値や p 値を出したいときは、=F.INV.RT(0.05, 2, 12)(3.885)と =F.DIST.RT(6, 2, 12)(0.015625)を使います。Microsoft の説明では、どちらも自由度に整数以外を入れると小数点以下が切り捨てられ、実際に =F.DIST.RT(6, 2.7, 12.9) は自由度 (2, 12) と同じ 0.015625 を返しました。F 分布そのものや2つの分散を比べる F 検定はF検定の記事で扱います。
二元配置には「分散分析: 繰り返しのある二元配置」と「分散分析: 繰り返しのない二元配置」があります。例題3を「繰り返しのある二元配置」で計算すると、分散分析表の行は「標本」(行方向の原因=分解法)、「列」(列方向の原因=試料の種類)、「交互作用」、「繰り返し誤差」、「合計」となり、値は上の表と一致しました。
もう1つ注意したいのは、分析ツールの出力は数式ではなく値で書き込まれることです(出力のセルを調べると数式が入っていません)。元のデータを直しても分散分析表は更新されないので、データを修正したら分析ツールをもう一度実行します。レポートに転記するときは、6 や 0.015625 のような表示をそのまま写さず、F は 6.00、p は 0.016 のように桁をそろえます(有効数字の記事)。
試験・レポートでの問われ方
大学の分析化学・物理化学実験や院試では、分散分析は次の形で問われます。
- 分散分析表の穴埋め:平方和と自由度の一部が与えられ、残りを埋めて F を求める。「平方和と自由度は縦に足すと合計」「平均平方 = 平方和 ÷ 自由度」「F = 群間 ÷ 群内」の3つで解ける
- 計算:3群程度のデータから例題1の手順で F を求め、F 分布の臨界値と比べて判定する。自由度 (k − 1, N − k) を正しく数えるのが採点の分かれ目
- t 検定を繰り返さない理由:1 − 0.95m の計算とともに、第一種の誤りが膨らむことを説明させる記述問題
- 平均を比べるのに分散を使う理由:差が無ければ群間と群内の平均平方がどちらも σ2 を推定することを説明できるか
- 精度の評価:分散分析表から併行標準偏差と再現標準偏差を求める(例題2)
実験レポートでは、班ごと・条件ごとの結果を並べて「ほぼ同じ値になった」「B だけ少し高かった」と書く代わりに、分散分析と多重比較で「試験室の効果は有意(F(2, 12) = 6.00、p = 0.016)で、差は B と A の間」と示せると、考察が具体的になります。その差が化学的に意味のある大きさか、原因は何かを考えるのは、統計ではなく化学の仕事です(考察の書き方は実験レポートの書き方)。検量線を使う定量なら、試験室の差の原因として、検量線の作り方の違いを疑うのも1つの手です。
まとめ
分散分析の計算は、結局「平均どうしの散らばりは、1回の測定の揺れから予想される大きさに比べて大きいか」という1つの問いを数にしたものです。群内の揺れが偶然の物差しになり、群間の散らばりをその物差しで測るのが F です。この見方を持っていれば、多重比較で MSW を使う理由も、精度を併行精度と室間再現精度に分けられる理由も、同じ1本の筋で説明できます。
よくある質問
分散分析(ANOVA)は、3つ以上の群の平均に差があるかを1回の検定で調べる方法です。全体のばらつき(総平方和)を、群の平均どうしの散らばり(群間平方和)と、同じ群の中の測定の揺れ(群内平方和)に分け、それぞれを自由度で割った平均平方の比 F を求めます。群に差が無ければ F はおよそ 1 になり、F が F 分布の臨界値より大きければ「母平均がすべて等しいとはいえない」と判定します。
検定を繰り返すほど、本当は差が無いのにどれか1つで偶然「有意」になる確率(第一種の誤り)が大きくなるからです。独立と仮定した概算では、3回で 1 − 0.953 = 14.3%、15回で 53.7% になります。各群5個のデータでシミュレーションすると、3群の総当たりで 12.3%、6群で 36.9% でした。分散分析や Tukey の方法は、全体としての誤りの確率を 5% に保つように作られています。
群内平方和は各群の平均からの偏差の2乗和の合計、群間平方和は各群のデータ数 ×(群の平均 − 総平均)の2乗の合計で、両者の和が総平方和になります。自由度は群間が 群の数 − 1、群内が 全データ数 − 群の数です。平均平方は平方和を自由度で割った値で、F は群間の平均平方を群内の平均平方で割って求めます。平方和と自由度は縦に足すと合計の行と一致するので、検算に使えます。
Excel の分析ツール「分散分析: 一元配置」の出力では、「変動」が平方和、「分散」が平均平方(変動 ÷ 自由度)、「観測された分散比」が F 値、「P-値」が F 分布の右側の確率、「F 境界値」が指定した有意水準の臨界値です。上の「概要」の表の「分散」は各群の標本分散で、分散分析表の「分散」とは別物です。観測された分散比が F 境界値より大きい、または P-値が 0.05 より小さければ、5% 水準で有意と判定します。
分散分析だけではわかりません。有意になって言えるのは「すべての母平均が等しいとはいえない」ことまでです。どの組に差があるかは多重比較で調べます。すべての組を比べるなら Tukey の方法(データ数が違えば Tukey–Kramer の方法)、前もって決めた少数の比較だけなら Bonferroni の方法(有意水準を比較の数で割る)を使います。分散分析が有意でも、多重比較でどの組も有意にならないことがあります。
参考文献
- D. Harvey, Analytical Chemistry 2.1, §14.3 Validating the Method as a Standard Method、§14.4 Using Excel and R for an Analysis of Variance(LibreTexts)
- NIST/SEMATECH, e-Handbook of Statistical Methods, §7.4.7 How can we make multiple comparisons?
- C. Y. Kramer, “Extension of Multiple Range Tests to Group Means with Unequal Numbers of Replications”, Biometrics 1956, 12, 307–310
- B. L. Welch, “On the Comparison of Several Mean Values: An Alternative Approach”, Biometrika 1951, 38, 330–336
- G. E. P. Box, “Some Theorems on Quadratic Forms Applied in the Study of Analysis of Variance Problems, I. Effect of Inequality of Variance in the One-Way Classification”, Annals of Mathematical Statistics 1954, 25, 290–302
- G. V. Glass, P. D. Peckham, J. R. Sanders, “Consequences of Failure to Meet Assumptions Underlying the Fixed Effects Analyses of Variance and Covariance”, Review of Educational Research 1972, 42, 237–288
- JIS Z 8402-2:1999「測定方法及び測定結果の精確さ(真度及び精度)-第2部:標準測定方法の併行精度及び再現精度を求めるための基本的方法」(ISO 5725-2:1994 に対応)
- GraphPad Prism Statistics Guide, “Relationship between overall ANOVA and multiple comparisons tests”
- Microsoft サポート「分析ツールを使用して統計学的および工学的分析を行う」「F.DIST.RT 関数」「F.INV.RT 関数」
関連記事
機器分析の全体像は機器分析総まとめ、実験操作は有機化学実験の基本操作まとめにまとめています。
- t検定のやり方とp値の意味|対応のある・ないの使い分けとExcelのT.TEST
- F検定とは?等分散の検定のやり方と臨界値・t検定の選び方|ExcelのF.TEST
- 外れ値の検定|グラブス検定とQ検定のやり方・臨界値と捨ててよい条件
- 標準偏差と標準誤差の違いとは?n-1で割る理由・相対標準偏差と変動係数
- 検出限界と定量限界の違いと求め方|S/N比・3.3σ/S・分析法バリデーション
- 誤差の伝播とは?不確かさの計算式と合成標準不確かさ・滴定の計算例
- 最小二乗法とは?傾きと切片の式の導出・標準誤差・決定係数とExcelの関数
- Excel(エクセル)の近似曲線|6種類の選び方・数式とR2乗値・検量線の例