外れ値の検定|グラブス検定とQ検定のやり方・臨界値と捨ててよい条件
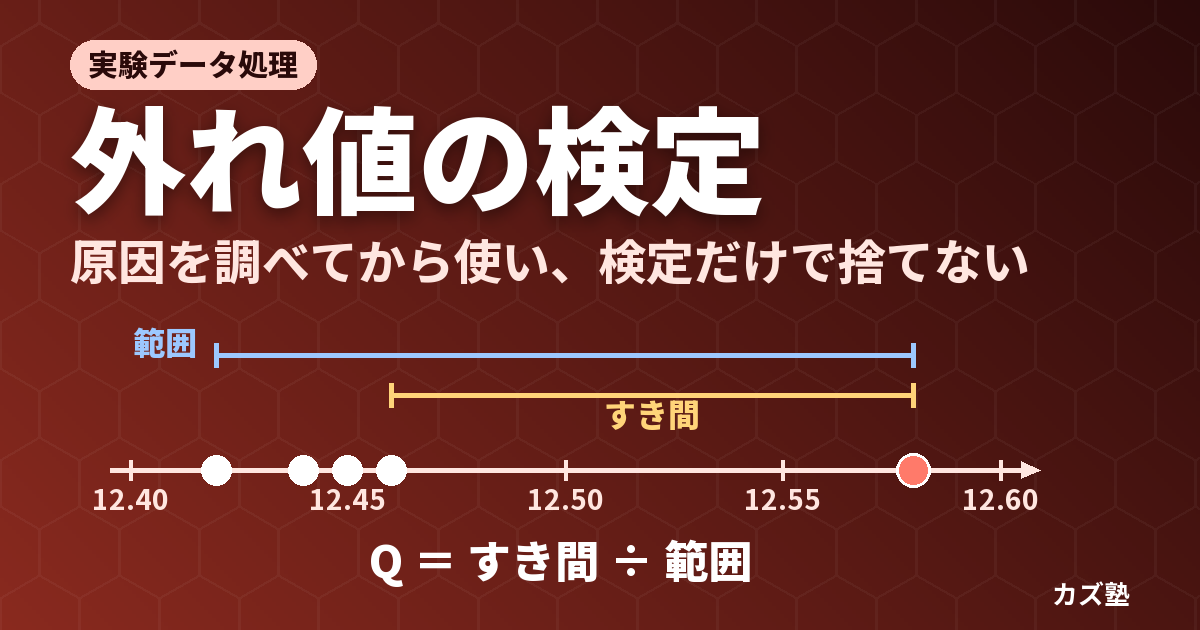
同じ塩酸を5回滴定したら、滴定量が 12.46、12.42、12.45、12.44、12.58 mL になりました。最後の1回だけ 0.1 mL 以上ずれています。この値を入れると平均は 12.47 mL、除くと 12.44 mL です。レポートの締め切りは明日。この 12.58 を「外れ値」として捨ててよいのでしょうか。
印象で捨てれば都合のよい値だけを残したことになり、おかしな値を残せば平均がゆがみます。そこで使われるのが外れ値の検定です。ただし、検定は「捨ててよい」という許可を出す道具ではありません。その理由まで含めて説明します。
外れ値とは:正規分布のデータでも「外れて見える点」は出る
Harvey の分析化学の教科書は、外れ値(outlier)を「ほかの測定値と整合しない測定値」と定義しています。ここで大事なのは、「整合しない」ように見える点が、何の失敗もなくても出てくることです。
外れて見える点が生まれる3つの理由
- 操作や記録の誤り:ビュレットの目盛りの読み違い、終点の行き過ぎ、気泡の混入、試料のこぼれ、転記ミス、単位の取り違え。原因があり、その1回だけが別の母集団から来た値です
- ばらつきの裾:測定値が正規分布に従っていても、平均から大きく離れた値はある確率で必ず出ます。この値を除くと、ばらつきを実際より小さく見積もることになります
- 系そのものの変化:試料が不均一だった、反応が途中で別の経路に進んだ、装置のドリフトが始まった。外れた点は、むしろ実験の重要な情報です
統計の検定が区別しようとするのは1つ目と2つ目です。3つ目は化学の知識と実験ノートで判断するしかありません。
「2s を超えたら捨てる」がうまくいかない理由
よく見かけるのが「平均から標準偏差の2倍(2s)以上離れた点は捨てる」という決め方です。正規分布では、1つの測定値が平均から 2σ 以上離れる確率は約 4.6% です。小さく見えますが、測定を何回もすれば話が変わります。σ がわかっているとしても、5回の測定のうち少なくとも1回が 2σ の外に出る確率は 20.8%、10回なら 37.2%、20回なら 60.6% です(p = 1 − 0.9545n で計算)。
実際には σ はわからず、同じデータから計算した s を使います。すると逆の問題も起こります。疑わしい点そのものが s を大きくするので、5回の測定ではどの点も 2s を超えることが原理的にできません(理由は後の「G には上限がある」で説明します)。10回の測定では、正規分布から乱数で作った何の問題もないデータの 23.4% で、少なくとも1点が 2s の外に出ました(正規乱数で10個のデータを200万組作って数えた値)。
つまり「2s ルール」では、誤って捨てる確率がデータ数によって変わります。外れ値の検定は、この確率をデータ数によらず決めた有意水準(5% や 1%)にそろえるように臨界値を作ったものです。標準偏差 s を n − 1 で割って求める理由は標準偏差と標準誤差の記事で扱っています。
検定の前に:記録を見直し、原因を探す
外れていそうな点が出たら、最初にやるのは検定ではなく記録の見直しです。
- 計算と転記を確かめる:滴定量の引き算(終読 − 初読)、単位、小数点の位置、Excel の参照セルのずれ。外れ値の多くはここで見つかる
- 実験ノートを読み返す:「終点で1滴多かった」「ビュレットの先に気泡」「セルに指紋」「この回だけ別のホールピペット」のような記述がないか
- 原因が見つかったら:直せるなら直す(計算ミスなど)。直せなければ、その点を除き、除いた理由を書く。このとき統計の検定は必要ない
- 原因が見つからないときだけ、検定を使う
この順番は規格の考え方とも一致しています。JIS Z 8402-2(ISO 5725-2 に対応する日本の規格)は、試験室間の共同実験のデータの扱いで、転記や計算の誤りのような技術的な誤りが見つかればまず訂正し、訂正できないものは除く、と定めています。英国王立化学会の分析法委員会(AMC)の技術解説も、外れ値の検定は「装置や記録の誤りのような明らかな説明が無い場合」に使うものだとしています。NIST の統計の手引きも、外れた観測値を単に削除したくはない、と書いています。
逆に、ノートに「この回はビュレットの先に気泡が残っていた」とあるのに「検定で有意でなかったから残す」のもおかしな判断です。その値は検定の結果に関係なく、別の条件で測った値です。
ディクソンの Q 検定:すき間 ÷ 範囲
Q 検定は、Dean と Dixon が 1951 年に Analytical Chemistry に発表した論文「少数の観測値のための簡略化した統計」を通じて化学の分野に広まった、少数のデータ向けの簡便な検定です。疑わしい点(最大値か最小値)と、そのいちばん近くの値との差(すき間)を、データ全体の範囲で割ります。
Q = |疑わしい値 − いちばん近い値| / (最大値 − 最小値)

Q > Q臨界値(n, α)なら、疑わしい値は外れ値と判定する
Q が大きいのは、疑わしい点だけがほかの点の集団から離れていて、範囲の大部分をその1点が占めているときです。割り算なので単位が消え、標準偏差を計算しなくても判定できるのが利点です。
臨界値は、正規分布に従う n 個のデータで Q がどこまで大きくなりうるかから決まります。簡単な式では書けないので、数表を使います。次の表は、Rorabacher が 1991 年に Analytical Chemistry に発表した臨界値(Harvey の教科書の付録に収録)です。
| データ数 n | α = 0.10 | α = 0.05 | α = 0.01 |
|---|---|---|---|
| 3 | 0.941 | 0.970 | 0.994 |
| 4 | 0.765 | 0.829 | 0.926 |
| 5 | 0.642 | 0.710 | 0.821 |
| 6 | 0.560 | 0.625 | 0.740 |
| 7 | 0.507 | 0.568 | 0.680 |
| 8 | 0.468 | 0.526 | 0.634 |
| 9 | 0.437 | 0.493 | 0.598 |
| 10 | 0.412 | 0.466 | 0.568 |
この表の α は、最大値と最小値のどちらが外れていても疑う(両側の)検定の値です。Harvey も、疑わしい点が最大値か最小値かがわかっていても、より保守的な両側の Q 検定を使うのがふつうだとしています。念のため、正規分布の乱数で5個・8個・10個のデータを40万組ずつ作り、両端のうち大きいほうの Q を計算すると、表の α = 0.05 の値を超えた割合は 5.0%、α = 0.01 の値では 1.0% で、表の α と一致しました。データを見てから「離れているほうの端」を選んで検定するのがふつうの使い方なので、表の値はそのまま使えます。データを見る前から「最大値だけを疑う」と決めていた場合だけは、実際の誤りの確率が表の α の半分になります(同じシミュレーションで 2.5%)。
例題1:滴定量の5回のデータを Q 検定で判定する
例題1:同じ塩酸 10.00 mL を NaOH 標準液で5回滴定し、滴定量が 12.46、12.42、12.45、12.44、12.58 mL になった(計算練習用の仮の値)。記録を見直しても原因は見つからなかった。12.58 mL は Q 検定で外れ値と判定されるか。
小さい順に並べると 12.42、12.44、12.45、12.46、12.58。すき間は 12.58 − 12.46 = 0.12 mL、範囲は 12.58 − 12.42 = 0.16 mL なので、Q = 0.12 / 0.16 = 0.750。n = 5 の臨界値は α = 0.05 で 0.710、α = 0.01 で 0.821。0.710 < 0.750 < 0.821 なので、5% では外れ値と判定されるが、1% では判定されない。
この「5% では捨てられるが、1% では捨てられない」という結果は、後で見る ISO 5725-2 の考え方では残す側に入ります。どちらの有意水準で判定するかを先に決めておかないと、結論を自分で選べてしまうことに注意してください。
3回の測定では、Q 検定はほとんど何も言えない
学生実験でいちばん多いのは、3回測って1回だけずれた、という場面です。ところが n = 3 の臨界値は α = 0.05 で 0.970、α = 0.10 でさえ 0.941 です。
例題3:3回の測定値が 10.10、10.12、10.40 だった(仮の値)。10.40 は外れ値か。
すき間 10.40 − 10.12 = 0.28、範囲 10.40 − 10.10 = 0.30、Q = 0.933。α = 0.05 の臨界値 0.970 どころか、α = 0.10 の 0.941 にも届かないので、外れ値とは判定できない。見た目では 10.40 だけが明らかに離れているが、3点では「2点がたまたま近くに並んだ」可能性を統計では否定できない。
3点しかないと、範囲そのものがとても不確かです。正規分布から3点をとると、2点がたまたま近くに並び、残りの1点が離れて見えることは珍しくありません。だから臨界値が 1 のすぐ手前まで上がります。3回測定で1回ずれたときは、検定で白黒をつけようとせず、原因を探すか、測定を追加するのが現実的です。追加した場合は、何回目から追加したかもレポートに書きます。
グラブス検定(スミルノフ・グラブス検定)
グラブス検定は、Frank E. Grubbs が 1950 年に Annals of Mathematical Statistics に発表し、1969 年に Technometrics で手順をまとめた検定です。日本ではスミルノフ・グラブス検定(Grubbs–Smirnov 検定)とも呼ばれます(オレフィンメタセシスのグラブス触媒のロバート・グラブスとは別人です)。疑わしい点が平均から標準偏差の何倍離れているかを測ります。
G = |x疑 − x| / s

x:疑わしい点も含めた全データの平均値
s:疑わしい点も含めた全データの標準偏差(n − 1 で割る。Excel の STDEV.S)
G > G臨界値(n, α)なら、疑わしい値は外れ値と判定する
Q 検定がいちばん近い点との「すき間」だけを見るのに対して、グラブス検定は全部の点から計算した平均と標準偏差を使います。データ全体の情報を使うぶん、Q 検定より安定した判定になります。Harvey の教科書は、ISO が Dixon の Q 検定よりもグラブス検定を勧めていることを紹介しています。
臨界値は t 分布から計算できる
グラブス検定の臨界値は、数表を見なくても t 分布から計算できます。NIST の統計の手引きが示している式は次のとおりです。
G臨界値 = [(n − 1) / √n] × √[ t2 / (n − 2 + t2) ]

t:自由度 ν = n − 2 の t 分布の上側 α/(2n) 点(両側検定)
   片側検定(最大値だけ、または最小値だけを調べる)なら上側 α/n 点
この式には2つの「なぜ」があります。
なぜ t 分布で、自由度が n − 2 なのか。疑わしい点を、残りの n − 1 個の点と比べることを考えます。残りの点の平均と標準偏差を使って「この1点は残りの集団からどれだけ離れているか」を t 値にすると、その t は自由度 n − 2(残り n − 1 個から平均を1つ決めたぶんを引く)の t 分布に従います。そして G は、この t を G = [(n − 1)/√n] × |t| / √(n − 2 + t2) と書き直したものになっています(乱数で作ったデータで、両辺が一致することを数値で確かめました)。t が大きいほど G も大きくなるので、t の臨界値をこの式に入れれば G の臨界値になります。
なぜ α を 2n で割るのか。検定するのは「n 個のうち、平均からいちばん遠い1点」です。どの点も同じだけ遠くに出る可能性があるので、1点あたりの誤りの確率を α/n に抑えれば、n 個全体で α 程度になります。さらに上下どちらに外れても疑う両側検定では、片側あたり半分の α/(2n) にします。この割り振りは一般には近似ですが、2 × G臨界値2 > n − 1 のときは厳密になります。偏差の2乗の合計は (n − 1)s2 なので、2点が同時に臨界値を超えることができず、「どれか1点が超える確率」がちょうど1点あたりの確率の n 倍になるからです。この記事の表の n = 4〜10 はすべてこの条件を満たします。実際に正規乱数の5個・8個・10個のデータを200万組ずつ判定させると、α = 0.05 の臨界値を超えた割合は 4.97%・5.00%・5.03% でした。
この式で計算した臨界値です(scipy で計算し、Excel でも同じ値になることを確かめました)。
| n | 両側 α = 0.05 | 両側 α = 0.01 | 片側 α = 0.05 | G の上限 (n − 1)/√n |
|---|---|---|---|---|
| 3 | 1.154 | 1.155 | 1.153 | 1.155 |
| 4 | 1.481 | 1.496 | 1.462 | 1.500 |
| 5 | 1.715 | 1.764 | 1.671 | 1.789 |
| 6 | 1.887 | 1.973 | 1.822 | 2.041 |
| 7 | 2.020 | 2.139 | 1.938 | 2.268 |
| 8 | 2.127 | 2.274 | 2.032 | 2.475 |
| 9 | 2.215 | 2.387 | 2.110 | 2.667 |
| 10 | 2.290 | 2.482 | 2.176 | 2.846 |
答え合わせとして、NIST の手引きの例(8個のデータの最大値を片側で検定、臨界値 2.032)と、Harvey の教科書の例(9個のデータ、α = 0.05 の臨界値 2.215)の値を、この式で再現できることを確かめています。教科書によって両側の値と片側の値のどちらを載せているかが違うので、数表を使うときは表の注を確かめてください。
G には上限がある:3回測定のグラブス検定が無力な理由
表の右端の列は、n 個のデータで G がとりうる最大の値です。1点だけをどんなに遠くに動かしても、G は (n − 1)/√n を超えられません。疑わしい点が遠くに行くほど、その点自身が標準偏差 s を大きくして、分母も一緒に大きくなるからです。残りの点がすべて同じ値のとき、G はちょうどこの上限になります。
n = 5 では上限が 1.789 で、2 に届きません。前の節で「5回の測定ではどの点も 2s を超えられない」と書いたのはこのためです。n = 3 では上限 1.1547 に対して、α = 0.05 の臨界値が 1.1543 です。例題3のデータ(10.10、10.12、10.40)では G = 1.1526 で、上限のすぐ近くなのに臨界値に届きません。3点で外れ値と判定されるのは、残りの2点がほぼ完全に一致しているときだけで、Q 検定の場合と同じく、3回測定に外れ値の検定はほとんど役に立ちません。
例題1をグラブス検定で判定する
例題1(続き):例題1の滴定量(12.46、12.42、12.45、12.44、12.58 mL)の 12.58 を、グラブス検定(両側)で判定せよ。
平均 x = 12.470 mL、標準偏差 s = 0.0632 mL(偏差 −0.01、−0.05、−0.02、−0.03、+0.11 の2乗和 0.0160 を 4 で割って平方根)。G = (12.58 − 12.470) / 0.0632 = 1.739。n = 5 の臨界値は、両側 α = 0.05 で t(自由度 3、上側 0.005 点)= 5.841 から 1.715、α = 0.01 で t(上側 0.001 点)= 10.21 から 1.764。1.715 < 1.739 < 1.764 なので、Q 検定と同じく5% では外れ値、1% では外れ値ではない。
2つの検定は別のものさしを使っていますが、この例では同じ結論になりました(図1)。12.58 を除くと平均は 12.4425 mL、標準偏差は 0.0171 mL になり、標準偏差は3分の1以下に縮みます。除くかどうかで平均が 0.03 mL 近く動くので、結論が変わりうる大きさです。だからこそ、どちらの有意水準で判定するかを先に決め、除いた場合も除かない場合も報告することが大切になります。
例題2:吸光度の8回のデータ(1% でも外れ値になる例)
例題2:同じ標準液の吸光度を同じセルで8回測定し、0.412、0.415、0.409、0.413、0.411、0.414、0.410、0.431 を得た(仮の値)。記録には特記事項がなかった。0.431 をグラブス検定(両側)で判定せよ。
平均 0.4144、標準偏差 0.00701。G = (0.431 − 0.4144) / 0.00701 = 2.372。n = 8 の臨界値は α = 0.05 で 2.127、α = 0.01 で 2.274 なので、1% でも外れ値と判定される。Q 検定でも Q = (0.431 − 0.415) / (0.431 − 0.409) = 0.016 / 0.022 = 0.727 で、α = 0.01 の臨界値 0.634 を超える。0.431 を除くと平均 0.4120、標準偏差 0.00216、相対標準偏差は 1.69% から 0.52% になる。
この場合は、検定のうえでは除くことを検討してよい点です。それでも、まず考えたいのは化学の側の原因です。吸光度が1回だけ高く出るなら、セルの外側の汚れや指紋、気泡、セルの向き、試料の取り違えなどが候補になります(逆に、高い吸光度が低く出るなら迷光も疑います)。ランベルト・ベールの法則の記事で、測定値がずれる原因を扱っています。原因が見つかれば、検定より強い除外の根拠になります。
Excel でグラブス検定をする
Excel にはグラブス検定の関数はありませんが、G と臨界値は組み合わせて計算できます。データが A2:A6(例題1)にあるときの例です。
B1 の G(最大値を疑う)  =(MAX(A2:A6)-AVERAGE(A2:A6))/STDEV.S(A2:A6)   → 1.739
   (離れているほうの端) =MAX(ABS(A2:A6-AVERAGE(A2:A6)))/STDEV.S(A2:A6) → 1.739
B2 の t(両側 α=0.05)  =T.INV.2T(0.05/5, 5-2)                        → 5.841
B3 の G の臨界値         =(5-1)/SQRT(5)*SQRT(B2^2/(5-2+B2^2))          → 1.715
判定                     =IF(B1>B3, "外れ値と判定", "外れ値と判定しない")
ポイントは T.INV.2T の第1引数です。T.INV.2T は「両側の確率」から t を返す関数なので、上側 α/(2n) 点がほしいときは、その2倍の α/n を渡します(例題1なら 0.05/5 = 0.01)。片側検定の上側 α/n 点なら 2α/n を渡します。自由度は n − 2 です。標準偏差は n − 1 で割る STDEV.S を使い、n で割る STDEV.P と取り違えないようにします(T.INV.2T と STDEV.S の扱いはt 検定の記事でも説明しています)。
Q 検定とグラブス検定の使い分け
| 比べる点 | ディクソンの Q 検定 | グラブス検定 |
|---|---|---|
| 統計量 | すき間 ÷ 範囲(3点しか使わない) | 平均からの距離 ÷ 標準偏差(全点を使う) |
| 臨界値 | 数表(Rorabacher 1991 など)。この記事の表は n = 3〜10 | t 分布から式で計算できる(Excel の T.INV.2T) |
| 規格での扱い | ISO は勧めていない(Harvey) | ISO 5725-2(JIS Z 8402-2)で使う |
| 弱点 | 疑わしい点が2つ並ぶと、すき間が小さくなって見逃す | 疑わしい点が2つあると、s が大きくなって見逃す |
| 共通の前提 | 外れ値以外のデータが正規分布に従う・各測定が独立。疑う点は1つ | |
手計算の試験問題では Q 検定がよく出ますが、レポートや論文でどちらか1つを選ぶなら、全データの情報を使い、規格でも使われ、臨界値を自分で計算できるグラブス検定が基本です。2つの検定を両方試して、捨てられたほうを採用するのは、検定を2回したのと同じで、誤って捨てる確率が上がります。使う検定は1つに決めておきます。
ISO 5725-2(JIS Z 8402-2)での位置づけ:コクラン検定とグラブス検定
外れ値の検定が規格の中でいちばんはっきり使われているのは、同じ試料を複数の試験室で分析して、分析法の精度を求める試験室間の共同実験です。ISO 5725-2(日本では JIS Z 8402-2)は、ここで2つの検定を順番に使うよう定めています。以下は JIS Z 8402-2:1999(ISO 5725-2:1994 に対応)の条文で確かめた内容です。
- コクラン検定(Cochran’s test):試験室の中のばらつき(室内変動)を調べる。各試験室の分散のうち最大のものが、分散の合計に占める割合 C = s2max / Σsi2 を臨界値と比べる。最初に適用する
- グラブス検定:主に試験室の間のばらつき(室間変動)を調べる。各試験室の平均値(セル平均)に適用し、コクラン検定でばらつきが大きいとされた試験室の中の測定結果にも使う。最大値が外れ値なら除いて反対側の極値に同じ検定を繰り返す(このときは片側2つの外れ値の検定は使わない)。最大値・最小値のどちらも外れ値と判定されなかったときは、外れ値が2つの場合の検定を行う
判定の区分が、この記事の考え方の核になります。
| 検定統計量 | JIS の呼び方 | 扱い |
|---|---|---|
| 5% の棄却限界値以下 | 正常 | そのまま使う |
| 5% を超え、1% 以下 | 5% 外れ値(*を1つ付ける) | 正しいものとして残す |
| 1% を超える | 1% 外れ値・統計的外れ値(**) | 統計解析者が妥当な理由で残すと判断しない限り除く |
つまり規格は、5% で有意になっただけでは捨てず、1% を除外の最低線にしています。5% で判定すると、問題のないデータでも20回に1回は「外れ値」が出ます。測定値を1つ捨てることは、残りのデータで計算する平均と精度を変えてしまうので、捨てる側の誤りを小さく抑えているわけです。例題1の 12.58 mL は、この区分では「5% 外れ値」で、残す側に入ります。
学生実験の5回の滴定は試験室間の共同実験ではないので、この規格がそのまま適用されるわけではありません。それでも、「原因を先に調べる」「5% と 1% の2段で考え、1% を超えなければ残す」「除いた点は印を付けて記録する」という考え方は、レポートでもそのまま使えます。試験室間の精度(併行精度・再現精度)を分散から求める方法は、分散分析(一元配置ANOVA)の記事で扱います。2つの分散の比を検定する考え方はF検定の記事につながります。
何度も繰り返して捨てない:マスキングとスワンピング
外れ値の検定でいちばん誤解されやすいのが、「1つ捨てたら、残りでもう一度検定して、また捨てる」という使い方です。ここには2つの別々の問題があります。
例題4:外れ値が2つあると、どちらの検定も見逃す
例題4:ある試料の濃度を8回測定し、5.02、5.05、4.99、5.01、5.03、5.00、5.31、5.33(mg/L、仮の値)を得た。5.31 と 5.33 は、後から調べると同じ日に調製した、汚染のあった希釈液で測った値だった。この事情を知らずに Q 検定とグラブス検定(α = 0.05、両側)をかけると、どうなるか。
Q 検定:最大値 5.33 のすき間は 5.33 − 5.31 = 0.02、範囲は 5.33 − 4.99 = 0.34 で、Q = 0.059。臨界値 0.526 よりはるかに小さい。グラブス検定:平均 5.0925、標準偏差 0.1417 で、G = (5.33 − 5.0925) / 0.1417 = 1.676。臨界値 2.127 に届かない。どちらの検定も、2つの外れた値を両方とも見逃す。外れた2点を除いた6点の標準偏差は 0.0216 で、2点を含めた 0.1417 の約6.6分の1しかない。
これがマスキング(masking)です。2つの外れ値が互いを隠しています。Q 検定では、5.33 のすぐ隣に 5.31 があるので、すき間がほとんど 0 になります。グラブス検定では、2点が一緒になって標準偏差を約6.6倍に膨らませ、分母が大きくなって G が小さくなります(図2の上)。NIST の手引きは、マスキングを「検定で想定する外れ値の数が少なすぎるときに起こる」ものと説明しています。逆に、想定する数が多すぎて、まともな点まで外れ値にしてしまうことをスワンピング(swamping)と呼びます。
注意したいのは、「1つずつ検定して、捨てたらまた検定する」を繰り返しても、マスキングは解けないことです。最初の1回目で何も見つからないので、2回目に進めないからです。NIST の手引きの54個のデータの例でも、グラブス検定を1つずつ繰り返すやり方は1回目で止まり、外れ値を1つも見つけられませんでした。
外れ値が2つ以上ありうるときの検定
外れ値が複数ありうるときは、そのために作られた方法を使います。
- 一般化 ESD 検定(Rosner 1983):疑う外れ値の数の上限 r を先に決め、平均からいちばん遠い点を1つずつ除きながら統計量 R1、…、Rr を全部計算し、それぞれの臨界値 λi と比べる。外れ値の数は「Ri > λi となる最大の i」で決める。途中で臨界値を下回っても止まらないのが、繰り返しのグラブス検定との違い。NIST の54個の例では外れ値3個を見つける(この記事の計算でも同じ値を再現した)
- ISO 5725-2 の2つの外れ値の検定:上側(または下側)の2点をまとめて除いたときに平方和がどれだけ減るかで判定する
例題4に一般化 ESD 検定(r = 2、α = 0.05)を当てはめると、1段目は R1 = 1.676 < λ1 = 2.127 で有意になりませんが、5.33 を除いた7点での2段目は R2 = 2.233 > λ2 = 2.020 となり、「外れ値は2個」という結論になります。ただし NIST は、この臨界値の近似は n ≥ 25 で非常に正確、n ≥ 15 でかなり正確としていて、8点では目安にとどまります。
見た目がそろうまで捨て続けると何が起こるか
もう1つの問題は、決められた手順の外で「捨てる → 残りで計算し直す → また捨てる」を繰り返すことです。1点捨てるたびに標準偏差は小さくなるので、さっきまで目立たなかった点が、新しい物差しでは外れて見えるようになります。
どのくらい起こるかを、正規分布の乱数で作った10点のデータ(本当は外れ値が1つも無い)で調べました。「2s を超えた点を除き、残りで計算し直して、また 2s を超えた点を除く」を繰り返すと、データの 23.4% で1点以上が捨てられ(1回目の判定は、前の節の「10回の測定の 23.4%」と同じです)、4.2% で2点以上が捨てられました。捨てられた場合、残ったデータの標準偏差は元の約7割(中央値で 0.68 倍)に縮みました。問題のないデータの4組に1組で、精度を実際より3割よく見せていることになります。
Harvey の教科書は、外れ値を除いた結果、精度が不確かさの伝播から期待される精度よりずっとよくなるなら、その除外は避けるべきだとしています。除外によって標準偏差がいくつになったかを、ビュレットの読み取りなど各操作の不確かさから見積もった精度(誤差の伝播の記事)と比べると、捨てすぎに気づけます。
箱ひげ図と四分位範囲(1.5×IQR)で目で見る
検定の前に、データを図で見ることも大切です。NIST の手引きも、グラブス検定の前提(正規分布)を確かめるために正規確率プロットを使い、箱ひげ図やヒストグラムも外れ値を見つける助けになるとしています。
箱ひげ図は、データを小さい順に並べたときの第1四分位数 Q1(25% の位置)、中央値、第3四分位数 Q3(75% の位置)で箱を描く図で、Tukey の探索的データ解析(1977 年)で広く知られるようになりました。箱の長さが四分位範囲 IQR = Q3 − Q1 です。NIST の手引きは次の線(フェンス)で外れ値を分類しています。
内側のフェンス:Q1 − 1.5 × IQR と Q3 + 1.5 × IQR (外に出た点=軽度の外れ値)
外側のフェンス:Q1 − 3 × IQR  と Q3 + 3 × IQR  (外に出た点=極端な外れ値)
中央値と四分位数は、外れた点が1つあってもほとんど動きません。だから、平均と標準偏差を使う検定と違って、外れた点が自分の物差しを膨らませることがありません。正規分布なら、Q3 は平均 + 0.674σ、IQR は 1.349σ なので、内側のフェンスは平均 ± 2.698σ にあたり、その外に出る割合は 0.70% です。
ただし、箱ひげ図のフェンスは図で見るための目安で、有意水準を決めた検定ではありません。正規分布から8点をとると、QUARTILE.INC の四分位数で描いた場合、何の問題もないデータの約 26% で、少なくとも1点が内側のフェンスの外に出ました(30点では約 34%)。QUARTILE.EXC の四分位数では約 8%(30点では約 23%)と、計算方法だけで大きく変わります。データ数が少ないと四分位数そのものが不安定だからです。
四分位数の計算方法が1つでないことにも注意が必要です。Excel には QUARTILE.INC と QUARTILE.EXC があり、例題2の吸光度8個では次のように値が変わります(Excel で実際に計算した値)。
| 関数 | Q1 | Q3 | IQR | 上側の内側/外側のフェンス |
|---|---|---|---|---|
| QUARTILE.INC | 0.41075 | 0.41425 | 0.0035 | 0.4195 / 0.42475 |
| QUARTILE.EXC | 0.41025 | 0.41475 | 0.0045 | 0.4215 / 0.42825 |
この例では、0.431 はどちらの計算でも外側のフェンスの外にあり、結論は変わりません。しかし境目に近い点では、関数の選び方だけで「外れ値」かどうかが変わります。この例の QUARTILE.EXC の値は、NIST の手引きの「(N + 1) × 0.25 番目」の位置の値(8個なら 2.25 番目)と一致しました。Excel の箱ひげ図([挿入] → [統計グラフ] → [ボックスとひげ])にも「包括的中央値」「除外中央値」という四分位数の計算方法の選択肢があります。図を載せるときは、どの方法で描いたかを書いておきます。
ロバストな代わり:中央値と MAD
外れ値を「捨てるか残すか」で悩む代わりに、外れ値に引っぱられにくい統計量(ロバストな統計量)で要約する方法もあります。平均の代わりに中央値、標準偏差の代わりに MAD(median absolute deviation:中央絶対偏差)を使います。
MAD = 中央値( |xi − 中央値| )
修正 z スコア Mi = 0.6745 × (xi − 中央値) / MAD
|Mi| > 3.5 の点を外れ値の候補とする(Iglewicz と Hoaglin の目安。NIST の手引きに収録)
0.6745 という数は、標準正規分布の上側 25% 点(Q3 の位置)です。正規分布では MAD がちょうど 0.6745σ になるので、0.6745 を掛けて MAD で割ると、ふつうの z スコア(σ を単位にした距離)と同じ目盛りになります。同じ理由で、MAD を 1/0.6745 = 1.4826 倍すると、正規分布のときに標準偏差 σ の推定値になります。
例題4に当てはめると、中央値は 5.025、MAD は 0.025 です。5.31 と 5.33 の修正 z スコアは 7.69 と 8.23 で、どちらも 3.5 を大きく超えます(図2の下)。中央値と MAD は8点の真ん中あたりの値だけで決まるので、外れた2点がいくら遠くにあってもほとんど動きません。平均と標準偏差の検定がマスキングで見逃した2点を、ここでは両方とも捉えられます。
Excel では、データが A2:A9 にあるとき、=MEDIAN(A2:A9) で中央値、=MEDIAN(ABS(A2:A9-MEDIAN(A2:A9))) で MAD が求まります(Microsoft 365 の Excel で 0.025 になることを確かめました)。
ただし、ロバストな統計量も万能ではありません。データが5点ほどだと MAD そのものが不安定で、例題1では MAD = 0.01 mL と小さく出るため、12.58 の修正 z スコアは 8.8 にもなります。Q 検定・グラブス検定が「5% と 1% の境目」とした点を、MAD は強く外れ値扱いするわけです。どの方法で要約したか、データ数はいくつかを書き添えて報告します。
レポートでの報告の書き方
外れ値を扱ったレポートで読み手が知りたいのは、「何を、なぜ、どの基準で除いたか」と「除かなかったら結果はどうだったか」です。この2つが書いてあれば、読み手は自分で判断し直せます。手順をまとめると図3のようになります。
例題1と例題2について、レポートの記述例を挙げます。
5回の滴定量のうち 12.58 mL は他の4回より大きかったが、実験ノートに原因となる記録は無かった。グラブス検定(両側)では G = 1.739 で、α = 0.05 の臨界値 1.715 は超えたが α = 0.01 の臨界値 1.764 は超えなかったため、除外せずに全5回の平均 12.47 mL(標準偏差 0.063 mL)を用いた。参考として、12.58 mL を除いた4回の平均は 12.44 mL(標準偏差 0.017 mL)である。
8回の吸光度のうち 0.431 は、グラブス検定(両側)で G = 2.372 となり、α = 0.01 の臨界値 2.274 を超えたため除外した。測定記録に原因は見当たらなかった。除外後の7回の平均は 0.4120(標準偏差 0.0022)、除外前の8回では 0.4144(標準偏差 0.0070)であった。
平均値と標準偏差をどの桁まで書くかは有効数字の記事、誤差棒の付いたグラフや表の書式はレポートの表・グラフの書き方、考察の文型は実験レポートの書き方で扱っています。外れ値を除いたあとで2つの条件の平均を比べるならt 検定に進みますが、t 検定の結果が外れ値を残すか除くかで変わるときは、その両方を書きます。
検量線の1点が外れているとき
ここまでの検定は、同じものを繰り返し測った値のための方法です。濃度の違う標準液を並べた検量線では、各点の y の値がそもそも違うので、y の値にそのまま Q 検定やグラブス検定をかけることはできません。検量線では、直線からのずれ(残差)を見て、残差のプロットで1点だけ大きく外れていないかを確かめます。1点が直線を引っぱる例と残差の見方は最小二乗法の記事、外れ値1つで相関係数が大きく変わる例は相関係数の記事、検量線の作り方そのものは検量線の記事で扱っています。
試験・レポートでの問われ方
大学の分析化学の演習や院試では、外れ値は次のような形で問われます。
- Q 検定の計算:データを並べ、すき間と範囲から Q を出して表の臨界値と比べる。すき間を「隣の点との差」でなく「平均との差」で計算する誤りが多い
- グラブス検定の計算:平均と標準偏差(n − 1 で割る)から G を出す。標準偏差は疑わしい点を含めて計算する
- 判定の書き方:「外れ値である」ではなく「有意水準 5% で外れ値と判定される(1% では判定されない)」のように、有意水準を添えて書く
- 記述問題:外れ値を捨てる前にすべきこと、外れ値が2つあるときの問題(マスキング)、3回測定で検定が役に立たない理由を説明させる
レポートで「誤差の大きい1回を除いた」とだけ書くのは、減点されやすい書き方です。測定値から計算した量の不確かさの見積もりは誤差の伝播の記事、繰り返し測定の精度の考え方は検出限界と定量限界の記事(分析法バリデーション)とつながります。
まとめ
統計が答えられるのは「偶然でこれほど遠くに出ることは珍しい」までで、「この値は間違いだ」とは言ってくれません。その先を決めるのは実験ノートと化学の知識です。検定は、捨てるための道具ではなく、調べる価値のある点を教えてくれる合図として使ってください。
よくある質問
外れ値の検定は、繰り返し測定したデータの中の疑わしい1点が、正規分布のばらつきだけで出るには遠すぎるかどうかを判定する方法です。代表的なものに、平均からの距離を標準偏差で割った G を使うグラブス検定(スミルノフ・グラブス検定)と、すき間を範囲で割った Q を使うディクソンの Q 検定があり、どちらも統計量を臨界値と比べて判定します。検定で有意になっても、それだけで捨ててよいことにはならず、先に記録を見直して原因を調べます。
データ数を n、有意水準を α とすると、自由度 n − 2 の t 分布の上側 α/(2n) 点 t を求め、[(n − 1)/√n] × √[t2/(n − 2 + t2)] で計算します(両側検定の場合。片側なら上側 α/n 点)。Excel では T.INV.2T(α/n, n − 2) で t が求まります。たとえば n = 5、α = 0.05 では t = 5.841 で、臨界値は 1.715 になります。
どちらか1つを選ぶなら、グラブス検定が基本です。全データの平均と標準偏差を使うので判定が安定し、臨界値を t 分布から計算でき、ISO 5725-2(JIS Z 8402-2)でも使われています。Q 検定は標準偏差を計算せずに判定できる簡便法で、手計算の試験問題でよく出ます。両方を試して捨てられたほうを採用すると、誤って捨てる確率が上がるので、使う検定は事前に1つに決めておきます。
ほとんど役に立ちません。データが3点のとき、Q 検定の臨界値は有意水準 5% で 0.970 と 1 のすぐ手前で、グラブス検定の G には 1.155 という上限があり、臨界値 1.154 とほぼ同じです。残りの2点がほぼ完全に一致していない限り、外れ値と判定できません。3回測定で1回だけずれたときは、記録を見直して原因を探すか、測定を追加して、そのことをレポートに書きます。
除いた値そのもの、除いた理由(記録上の原因か、検定の結果か)、使った検定の名前と有意水準、統計量と臨界値、そして除く前と除いた後の平均と標準偏差を書きます。除く前の結果も書いておくと、読み手が判断をやり直せます。ISO 5725-2(JIS Z 8402-2)の考え方では、有意水準 5% で有意になっただけの点は残し、1% でも有意な点を除外の対象にします。
参考文献
- D. Harvey, Analytical Chemistry 2.1, §4.6 Statistical Methods for Normal Distributions(Outliers)、付録 16.6 Critical Values for Dixon’s Q-Test(LibreTexts)
- NIST/SEMATECH, e-Handbook of Statistical Methods, §1.3.5.17 Detection of Outliers、§1.3.5.17.1 Grubbs’ Test for Outliers、§1.3.5.17.3 Generalized ESD Test for Outliers、§7.1.6 What are outliers in the data?
- JIS Z 8402-2:1999「測定方法及び測定結果の精確さ(真度及び精度)—第2部:標準測定方法の併行精度及び再現精度を求めるための基本的方法」(ISO 5725-2:1994 に対応)
- D. B. Rorabacher, “Statistical Treatment for Rejection of Deviant Values: Critical Values of Dixon’s ‘Q’ Parameter and Related Subrange Ratios at the 95% Confidence Level”, Analytical Chemistry 1991, 63, 139–146
- R. B. Dean, W. J. Dixon, “Simplified Statistics for Small Numbers of Observations”, Analytical Chemistry 1951, 23, 636–638
- F. E. Grubbs, “Sample Criteria for Testing Outlying Observations”, Annals of Mathematical Statistics 1950, 21, 27–58
- F. E. Grubbs, “Procedures for Detecting Outlying Observations in Samples”, Technometrics 1969, 11, 1–21
- F. E. Grubbs, G. Beck, “Extension of Sample Sizes and Percentage Points for Significance Tests of Outlying Observations”, Technometrics 1972, 14, 847–854
- B. Rosner, “Percentage Points for a Generalized ESD Many-Outlier Procedure”, Technometrics 1983, 25, 165–172
- B. Iglewicz, D. C. Hoaglin, How to Detect and Handle Outliers(The ASQC Basic References in Quality Control: Statistical Techniques, Vol. 16), ASQC Quality Press, 1993
- J. W. Tukey, Exploratory Data Analysis, Addison-Wesley, 1977
- Analytical Methods Committee, “Using the Grubbs and Cochran tests to identify outliers”, AMC Technical Brief No. 69, Analytical Methods 2015, 7, 7948–7950
- Microsoft サポート「QUARTILE.INC 関数」「QUARTILE.EXC 関数」「T.INV.2T 関数」「箱ひげ図を作成する」
関連記事
機器分析の全体像は機器分析総まとめ、実験操作は有機化学実験の基本操作まとめにまとめています。
- 標準偏差と標準誤差の違いとは?n-1で割る理由・相対標準偏差と変動係数
- t検定のやり方とp値の意味|対応のある・ないの使い分けとExcelのT.TEST
- F検定とは?等分散の検定のやり方と臨界値・t検定の選び方|ExcelのF.TEST
- 分散分析とは?一元配置のやり方と分散分析表の読み方|F値・p値とExcel
- 最小二乗法とは?傾きと切片の式の導出・標準誤差・決定係数とExcelの関数
- 誤差の伝播とは?不確かさの計算式と合成標準不確かさ・滴定の計算例
- 検出限界と定量限界の違いと求め方|S/N比・3.3σ/S・分析法バリデーション
- 実験レポートの書き方|テンプレートと考察の例文【有機化学実験の記入例】