F検定とは?等分散の検定のやり方と臨界値・t検定の選び方|ExcelのF.TEST
新しく立ち上げた分析法で同じ試料を5回測ったら、標準偏差が従来法の2倍になりました。「新しい方法は精度が悪い」とレポートに書いてよいでしょうか。答えは「このデータだけでは言えない」です。5回ずつのデータで2つの方法の精度の違いを判定する F 検定は、標準偏差が約3.1倍以上違わないと「有意」になりません。たった5回から求めた標準偏差は、それ自体が大きく揺れるからです。
F 検定は、分析化学では「2つの分析法・2台の装置・2人の実験者のどれが精度がよいか」を比べるときに使われ、教科書では t 検定の前に「分散を合算してよいか」を調べる手順としても登場します。ところが後者の使い方は、統計学ではむしろ勧められていません。この記事では、F が分散の「差」ではなく「比」になる理由から始めて、臨界値の読み方、Excel の3つの関数の違い、そして t 検定の選び方との関係までを、実験データの例題で計算しながらつなげます。平均の比べ方はt 検定の記事で扱っているので、ここでは「ばらつきを比べる」ことに集中します。
F 検定とは:2つの分散の比で精度を比べる
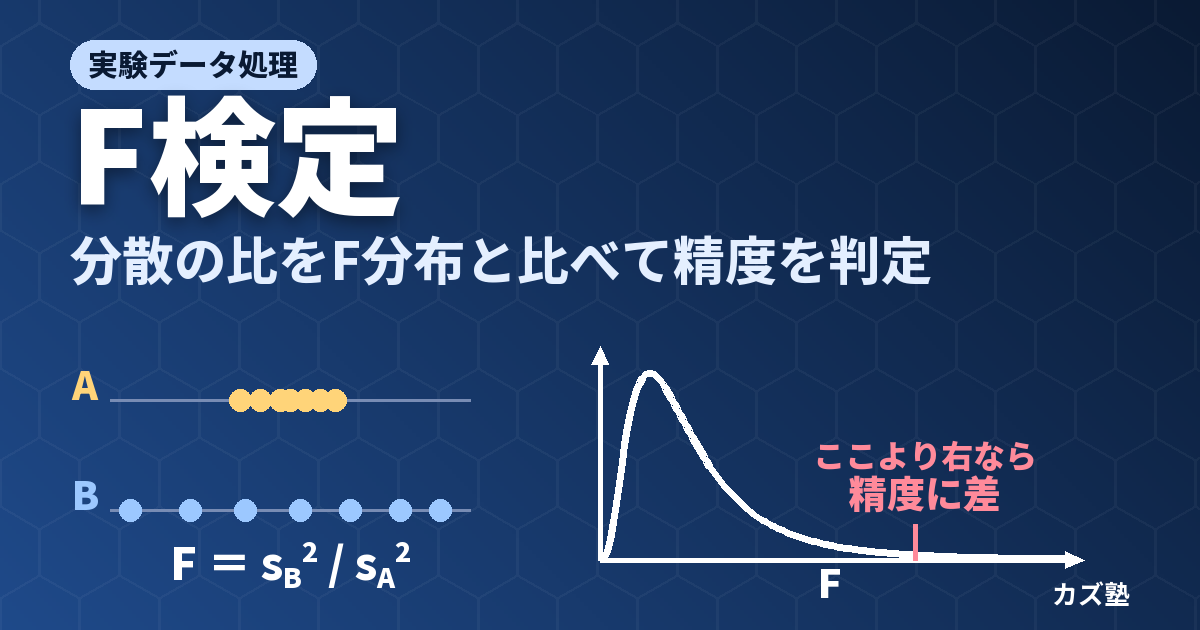
同じ試料を繰り返し測ったときのばらつきの大きさは、標準偏差 s(n − 1 で割ったもの)やその2乗の分散 s2 で表します(定義と n − 1 で割る理由は標準偏差と標準誤差の記事)。2つのデータの精度を比べたいとき、知りたいのは「2つの母分散 σ12 と σ22 は等しいか」です。F 検定では、その手がかりとして2つの標本分散の比をとります。
F = s12 / s22

s12, s22:2つのデータの分散(n − 1 で割ったもの。Excel の VAR.S)
自由度:分子 ν1 = n1 − 1、分母 ν2 = n2 − 1
帰無仮説 H0:σ12 = σ22(2つの母分散は等しい)
母分散が等しければ F は 1 の近くに出て、1 から離れるほど「ばらつきが違う」ことを示します。ただし、等しくても F がぴったり 1 になることはまずありません。どこまで離れたら偶然では説明しにくいかを決めるのが、次に見る F 分布です。
なぜ差ではなく比なのか
平均の比較(t 検定)では差をとったのに、分散の比較ではなぜ比をとるのでしょうか。理由は、比にすると、わからない母分散が式から消えるからです。
測定値が正規分布に従うとき、(n − 1)s2/σ2 は自由度 n − 1 のカイ二乗分布という決まった分布に従います。つまり s2/σ2 の揺れ方は、σ がいくつであってもデータ数だけで決まります。母分散が等しい(σ1 = σ2)なら、比 s12/s22 の中で σ は約分されて消え、F の分布は2つの自由度だけで決まります。これが F 分布で、NIST の手引きの言い方では「2つのカイ二乗分布を、それぞれの自由度で割ってからとった比」の分布です。
差 s12 − s22 ではこうはいきません。同じ「等分散」でも、σ が大きい測定では差も大きく揺れるので、差の大きさだけでは判定できないのです。分散はもともと「倍」で効く量(標準偏差が2倍なら分散は4倍)なので、比で比べるのが自然でもあります。
F 分布と2つの自由度
F 分布は 0 以上の値だけをとり、右に長い裾を引く形をしています。形を決めるのは分子の自由度 ν1 と分母の自由度 ν2 の2つで、t 分布(自由度1つ)より1つ多いのが特徴です。Excel の関数でも、自由度は「自由度 1(分子)」「自由度 2(分母)」の順に2つ指定します。
自由度が小さいと分布は横に大きく広がります。5回ずつ(自由度 (4, 4))なら、母分散が等しくても F が 9.60 を超えるか 0.104 を下回ることが合わせて 5% あります。30回ずつ(自由度 (29, 29))なら、その範囲は 0.476〜2.10 まで狭まります(図1)。
図1の右の表の「s の比なら」の列は、上側の臨界値の平方根です。5回ずつ測った2つのデータでは、標準偏差の比が 3.10 倍を超えて初めて両側 5% で有意になり、10回ずつでも 2.01 倍が必要です。これほど広いのは、少ないデータから求めた標準偏差が大きく揺れるからです。正規分布に従う測定を5回して求めた s は、母標準偏差 σ の 0.35 倍から 1.67 倍の範囲に 95% の確率でばらつきます(自由度 4 のカイ二乗分布から計算)。この揺れを2つ分抱えた比なので、F の臨界値は 1 から大きく離れるのです。
大きい方の分散を分子にする理由と、両側検定の関係
F 検定の書き方には2つの流儀があります。NIST の手引きは、1つ目のデータの分散を分子に固定して F = s12/s22 とし、両側検定では「F が下側の臨界値より小さいか、上側の臨界値より大きいとき」に棄却します。一方、Harvey の教科書をはじめ化学の教科書の多くは、大きい方の分散を分子にして F ≥ 1 にそろえ、上側の臨界値1つとだけ比べます。
2つのやり方が同じ結論を出すのは、F 分布に次の性質があるからです。
下側 2.5% 点 F0.025(ν1, ν2) = 1 / 上側 2.5% 点 F0.975(ν2, ν1)

例:自由度 (6, 5) の下側 2.5% 点 = 0.1670
    自由度 (5, 6) の上側 2.5% 点 = 5.988 → 1 / 5.988 = 0.1670
分子と分母を入れ替えると F は逆数になり、自由度の順番も入れ替わります。だから「小さい方を分子にした F が下側の臨界値より小さい」ことは、「大きい方を分子にした F が、自由度を入れ替えた上側の臨界値より大きい」ことと同じです。大きい方を分子にして上側 2.5% 点と比べるのは、両側 5% の検定そのもので、下側を見る手間を省いているだけです。
ここで間違えやすいのが、臨界値の確率です。大きい方を分子にしたとき、上側 5% 点と比べると、実際には両側 10% の検定をしたことになります。分子を「大きい方」とデータを見てから選んでいる以上、逆向きの可能性(もう一方が大きかった場合)の 5% も、すでに使ってしまっているからです。Harvey の教科書が例題で使う臨界値 F(0.05, 6, 4) = 9.197 や F(0.05, 5, 5) = 7.15 は、計算すると F 分布の上側 2.5% 点、つまり両側 5% の値です。
片側検定(上側 5% 点を使う)が正しいのは、「新しい装置のほうが精度がよいか」のように、どちらの分散が大きいはずかをデータを見る前に決めていて、その向きの分散を分子にしたときだけです。このとき、逆向きに出たら(F < 1 になったら)計算するまでもなく「有意でない」です。
F 検定の手順
手順は t 検定と同じ5段階です(仮説の立て方と p 値の意味はt 検定の記事で詳しく扱っています)。
- 仮説を立てる:帰無仮説 H0:σ12 = σ22。対立仮説は、両側なら σ12 ≠ σ22、片側なら σ12 > σ22 のように向きを決める
- 有意水準 α と、両側か片側かを決める:データを見る前に決める
- F と自由度を計算する:両側なら大きい方の分散を分子に、片側なら対立仮説で大きいとした側を分子にする。自由度は分子・分母それぞれ「データ数 − 1」
- 臨界値と比べるか、p 値を求める:両側 5% なら上側 2.5% 点、片側 5% なら上側 5% 点と比べる
- 結論を書く:F・自由度・p 値を書き、「精度に有意な差がある」「有意な差があるとはいえない」と書く。「精度は同じだった」とは書かない
例題1:2つの分析法の精度を比べる(両側検定)
例題1:同じ水道水の試料のカルシウム濃度を、EDTA によるキレート滴定で6回、フレーム原子吸光分析で7回測定した(数値は計算練習用の仮の値。単位 mg/L)。2つの方法の精度に差があるといえるか。有意水準 5%、両側で判定せよ。
キレート滴定(6回):40.3, 40.5, 40.2, 40.6, 40.4, 40.3
原子吸光(7回)    :40.7, 40.0, 40.6, 40.9, 40.2, 40.3, 40.8
どちらが精度がよいはずかを事前に決める理由が無いので、両側検定にします。
キレート滴定:平均 40.383 mg/L、偏差の2乗和 0.10833、分散 s2 = 0.10833 / 5 = 0.02167、s = 0.147 mg/L
原子吸光:平均 40.500 mg/L、偏差 0.2, −0.5, 0.1, 0.4, −0.3, −0.2, 0.3 の2乗和 0.6800、分散 s2 = 0.6800 / 6 = 0.1133、s = 0.337 mg/L
大きい方(原子吸光)を分子にして F = 0.1133 / 0.02167 = 5.23、自由度 (6, 5)
両側 5% の臨界値(上側 2.5% 点)F0.975(6, 5) = 6.98。5.23 < 6.98 なので帰無仮説を棄却できない。p = 0.090(両側)
結論:精度に有意な差があるとはいえない(F = 5.23、自由度 6 と 5、p = 0.090)。
標準偏差は 0.337 対 0.147 で2.3倍も違うのに、有意になりません。ここで「上側 5% 点」F0.95(6, 5) = 4.95 と比べてしまうと、5.23 > 4.95 で「有意」と判定してしまいます。これが前の節で見た間違いで、大きい方を分子にしたうえで片側の値を使っているので、実際の有意水準は 10% です。
「有意でない」ときに書けること:母分散の比の信頼区間
有意でなかったからといって、2つの方法の精度が同じだと言えるわけではありません。どこまでの違いがありうるかは、母分散の比の信頼区間で示せます。
σ12/σ22 の 95% 信頼区間 = F / F0.975(ν1, ν2) 〜 F / F0.025(ν1, ν2)

例題1:5.23 / 6.98 〜 5.23 / 0.1670 = 0.75 〜 31.3
標準偏差の比に直すと(平方根)    0.87 〜 5.6 倍
このデータは、「原子吸光のほうが少し精度がよい(0.87倍)」から「5.6倍も悪い」までのどれとも矛盾しません。区間が 1 を含むので有意にはならず、しかも非常に広い。言えるのは「精度の違いを決めるには、回数が足りない」ということです。ちなみに F 検定は平均には触れません。2つの方法の平均が 40.38 と 40.50 で違うかどうかは、別に t 検定で調べる問題です。
例題2:新しい装置で精度は上がったか(片側検定)
例題2:HPLC のオートサンプラーを新しい機種に替えた。替える前と後で、同じ標準溶液を10回ずつ注入し、ピーク面積(任意単位)を得た(仮の値)。新しいオートサンプラーで注入の繰り返し精度は上がったといえるか。有意水準 5% で判定せよ。
旧(10回):1523, 1508, 1531, 1515, 1540, 1502, 1526, 1519, 1535, 1511
新(10回):1515, 1526, 1519, 1525, 1512, 1523, 1521, 1514, 1528, 1517
この実験の目的は「新しい機種で精度が上がったか」で、逆向き(悪くなった)は問いません。目的がデータを見る前から決まっているので、片側検定が使えます。対立仮説は σ旧2 > σ新2 なので、旧の分散を分子にします。
旧:平均 1521.0、分散 150.67、s = 12.27(相対標準偏差 0.81%)
新:平均 1520.0、分散 30.00、s = 5.48(相対標準偏差 0.36%)
F = 150.67 / 30.00 = 5.02、自由度 (9, 9)
片側 5% の臨界値(上側 5% 点)F0.95(9, 9) = 3.18。5.02 > 3.18 なので帰無仮説を棄却する。p = 0.012(片側)
結論:新しいオートサンプラーで注入の繰り返し精度は有意に上がった(F = 5.02、自由度 9 と 9、片側 p = 0.012)。
この例では、両側で検定しても p = 0.025(臨界値 4.03)で有意になります。片側検定の価値は、境目に近いデータで差を見つけやすくなることですが、それは「向きを事前に決めていた」場合に限ります。結果を見てから片側に切り替えるのは、t 検定と同じく許されません。
例題2のように同じ溶液を測るなら、平均がほぼ同じなので分散をそのまま比べられます。標準偏差の記事の例題4のように分取量が違って測定値の大きさそのものが違うときは、標準偏差ではなく相対標準偏差の比の2乗で比べます。注入のばらつきがどんな定量法で問題になるかは、検量線の記事の絶対検量線法と内部標準法の節で扱っています。
Excel で F 検定をする:F.TEST・F.DIST.RT・F.INV.RT の違い
Excel には F 分布の関数がいくつもあり、名前が似ているので混同しがちです。返すものの違いを表にまとめます(Microsoft の説明による)。
| 関数 | 返すもの | 例題1での値 |
|---|---|---|
| F.TEST(配列 1, 配列 2) | 2つのデータの分散に有意な差が無いとしたときの両側の確率(p 値)。データから直接計算する | 0.0898(配列の順番を入れ替えても同じ) |
| F.DIST.RT(x, 自由度 1, 自由度 2) | F が x より大きくなる確率 P(F > x)。右側(上側)の片側の確率 | F.DIST.RT(5.23, 6, 5) = 0.0449。2倍すると両側 0.0898 |
| F.INV.RT(確率, 自由度 1, 自由度 2) | 右側の確率がその値になる F。臨界値(確率に有意水準を入れる) | F.INV.RT(0.025, 6, 5) = 6.98(両側 5%)、F.INV.RT(0.05, 6, 5) = 4.95(片側 5%) |
| F.DIST(x, 自由度 1, 自由度 2, TRUE) | F が x 以下になる確率(左側の累積)。FALSE なら確率密度 | 0.9551(= 1 − 0.0449) |
| F.INV(確率, 自由度 1, 自由度 2) | 左側の累積確率がその値になる F | F.INV(0.975, 6, 5) = 6.98、F.INV(0.025, 6, 5) = 0.167 |
例題1のデータを、キレート滴定を A2:A7、原子吸光を B2:B8 に入れて計算すると次のようになります(Excel で実際に計算し、scipy の値と一致することを確かめた値です)。
分散(滴定)   =VAR.S(A2:A7)                          → 0.02167
分散(原子吸光)=VAR.S(B2:B8)                          → 0.1133
F(C2)        =VAR.S(B2:B8)/VAR.S(A2:A7)              → 5.23
両側 p 値      =F.TEST(A2:A7, B2:B8)                    → 0.0898
同じ値         =2*F.DIST.RT(C2, 6, 5)                   → 0.0898
臨界値(両側5%)=F.INV.RT(0.025, 6, 5)                  → 6.978
F.TEST は順番を気にしなくてよい、F.DIST.RT は気にする
F.TEST はデータの範囲を2つ渡すだけで両側の p 値を返し、どちらを先に書いても値は同じです。Microsoft の公式の例(5個ずつの2組で 0.64831785)も、scipy で「分子を固定した F の、小さいほうの裾の確率の2倍」として計算すると同じ値になり、F.TEST がこの定義の両側確率を返していることが確かめられます。
一方、F.DIST.RT は右側の確率だけを返すので、F を 1 以上にしてから渡し、自由度も分子・分母の順に合わせる必要があります。小さい方を分子にした F = 0.191 を F.DIST.RT に渡すと、自由度の順番しだいで 0.955 や 0.966 が返りますが、これは p 値としては意味のない値です。また、片側の確率なので、両側の p 値にするには2倍します。F.DIST.RT・F.INV.RT・F.DIST は、自由度に小数を入れると切り捨てられます(自由度 6.9 と 5.9 を渡すと、自由度 6 と 5 と同じ値が返ることを確かめました)。
分析ツール「F 検定: 2 標本を使った分散の検定」の読み方
Excel の分析ツールにも「F 検定: 2 標本を使った分散の検定」があります。Microsoft の説明によると、このツールは F の値 f を計算し、出力の「P(F <= f) 片側」は、f > 1 なら f より大きい F が出る確率、f < 1 なら f より小さい F が出る確率です。「F 境界値 片側」も、f > 1 なら 1 を超える境界値、f < 1 なら 1 未満の境界値になります。
ここから読み取るべき注意は2つあります。1つ目は、出力が片側だということです。両側 5% で判定するなら、p 値を2倍して 0.05 と比べるか、分散の大きい方のデータを「変数 1」に入れて(f > 1 にして)、ダイアログの α に 0.025 を入れて境界値を求めます。分散の小さい方を変数 1 に入れると f < 1 になり、1 未満の境界値が出ます。2つ目は、行の名前が「<=」でも、f > 1 のときは右側の確率だということです。名前どおりに「f 以下の確率」と読むと、意味を取り違えます。分析ツールの有効化のしかたはt 検定の記事の分析ツールの節と同じで、Excel のグラフと近似曲線の操作はExcel の近似曲線の記事で扱っています。
t 検定の前の等分散の検定:Student と Welch の選び方
F 検定がいちばんよく出てくるのは、実は t 検定の前です。対応のない2群の平均を比べる t 検定には、2群の分散を合算する Student の t 検定と、合算しない Welch の t 検定があります(違いはt 検定の記事)。そこで「先に F 検定で分散が等しいか調べ、等しければ Student、違えば Welch」という二段階のやり方が生まれました。
この手順は教科書にもあります。Harvey の分析化学の教科書は、分散を合算してよいかをどう決めるかという問いに「F 検定を使う」と答え、F 検定で有意な差がなければ合算して t を計算する例題を載せています。分析化学の講義や実験書でこの手順を習った人も多いでしょう。
例題3:t 検定の記事の例題3のデータで F 検定をする
例題3:同じ塩酸を実験者 X が8回、実験者 Y が4回滴定した(t 検定の記事の例題3と同じ仮の値。単位 mmol/L)。2人の分散に差があるか、両側 5% で F 検定せよ。
X(8回):101.2, 100.9, 101.1, 101.0, 101.3, 101.1, 101.0, 101.2   分散 0.01714
Y(4回):102.8, 101.2, 103.1, 101.3                                 分散 0.9800
大きい方(Y)を分子にして F = 0.9800 / 0.01714 = 57.2、自由度 (3, 7)
両側 5% の臨界値 F0.975(3, 7) = 5.89。57.2 > 5.89 なので帰無仮説を棄却する。p = 5.5 × 10⁻⁵(両側。Excel の F.TEST も同じ値)
二段階のやり方なら「分散は等しくない → Welch」と進み、Welch の t 検定で t = 2.01、自由度 3.05、p = 0.136。Student の t 検定(t = 2.95、p = 0.014)とは結論が分かれる。
この例では F 検定がはっきり分散の違いを見つけたので、二段階のやり方でも結局 Welch に行き着きます。問題は、いつもこう都合よくいくとは限らないことです。
理由1:少ない回数の F 検定は、分散の違いを見逃す
F 検定が分散の違いを見つける確率(検出力)を計算してみます。本当の標準偏差の比が決まっているとき、両側 5% の F 検定が有意になる確率は、F 分布から正確に計算できます。
| 各群のデータ数 | 標準偏差の比 1.5 | 標準偏差の比 2 | 標準偏差の比 3 |
|---|---|---|---|
| 5 | 10% | 21% | 48% |
| 10 | 20% | 50% | 88% |
| 20 | 40% | 84% | 99.6% |
| 50 | 80% | 99.8% | ほぼ 100% |
実験でよくある5回ずつの測定では、本当に標準偏差が2倍違っても、F 検定が有意になるのは5回に1回程度(21%)です。残りの約8割は「有意でない」になります。80% の確率で見つけるには、各群19回の測定が要ります(図2)。
二段階のやり方では、この「有意でない」を「分散は等しい」と読み替えて Student に進みます。ところが Student の t 検定が困るのは、まさに分散がそこそこ違うのに F 検定が見逃す場面です。Delacre らも、等分散の検定(Levene 検定)は標本が小さく、大きさが違うときに検出力がとても低いことを、二段階のやり方の問題として挙げています。F 検定で有意にならないことは、等分散の証明ではないのです。
標準偏差の記事の例題4(5回ずつ・相対標準偏差 0.33% と 0.21%)を F 検定にかけると、F = 2.40、自由度 (4, 4)、p = 0.42 で有意ではありません。しかし母分散の比の 95% 信頼区間は 0.25〜23(標準偏差の比で 0.50〜4.8 倍)で、「同じ精度」とはとても言えない幅です。
理由2:二段階にすると、誤りの確率がずれる
二段階のやり方で最終的な t 検定の誤りの確率がどうなるかは、数式では簡単に書けないので、数値実験(シミュレーション)で確かめます。t 検定の記事の例題3と同じく、ばらつきの大きい群が4回、小さい群が8回という組み合わせで、母平均は等しい(本当は差が無い)データを乱数で20万組ずつ作り、両側 5% で「有意」と出た割合を数えました(乱数の種を固定した計算で、5% 付近の値の揺れは ±0.1 ポイント程度です)。
| 母標準偏差の比(4回の群 ÷ 8回の群) | 1 | 1.5 | 2 | 3 | 5 |
|---|---|---|---|---|---|
| いつも Student | 5.0% | 8.6% | 11.8% | 16.3% | 19.9% |
| 先に F 検定で選ぶ | 5.1% | 8.0% | 9.9% | 10.5% | 7.8% |
| いつも Welch | 5.1% | 5.7% | 5.9% | 6.0% | 5.6% |
| (参考)F 検定が分散の違いに気づく割合 | 5.0% | 14% | 31% | 60% | 87% |
二段階のやり方は、いつも Student を使うよりはましですが、5% には戻りません(図3)。標準偏差の比が2のとき、F 検定が違いに気づくのは31%だけで、残りの約7割は Student に進みます。しかも、F 検定が有意にならなかったデータは「たまたま分散の違いが小さく見えた」データなので、そこで Student を使ったときの誤りは 14.0% と、いつも Student を使う場合(11.8%)よりさらに悪くなります。おもしろいのは、ずれが最も大きいのが分散の違いが中くらいのとき(比 2〜3 で約10%)で、比が5まで開くと F 検定が気づきやすくなって 7.8% まで戻ることです。Zimmerman(2004)もシミュレーションで、二段階の手順は有意水準(名目の 5%)を守れず、多くの場合かえって状況を悪くすること、そのずれは標本が小さいほど大きく、分散の違いが極端なときよりもわずかなときのほうが大きいことを報告しています。
逆の組み合わせ(ばらつきの大きい群が8回、小さい群が4回)では、標準偏差の比が 2 のとき、同じ計算で Student の誤りは 2.2% と 5% より小さくなり(そのぶん本当の差を見逃しやすくなる)、二段階では 2.8%、Welch では 4.5% でした。どちらの向きでも、Welch が約束の 5% にいちばん近いことは変わりません。
Zimmerman は、予備の検定で必要と出たときだけ Welch を使うと、Welch 自身の妥当性も落ちると指摘しています。上の数値実験でも、標準偏差の比が 2 で F 検定が有意になり Welch に進んだデータだけを見ると、誤りは 0.8% と 5% よりずっと小さくなりました(F 検定が有意になるのは、たまたま分散の違いが大きく見えたデータに偏るため)。Welch は「いつも使う」ときに 5% 前後に保たれる方法で、F 検定でふるい分けたデータに使うと性質が変わってしまうのです。
結論:Student か Welch かは、データを見る前に Welch に決めておく
こうした理由から、t 検定の前に等分散の検定をする二段階のやり方は勧められず、2群の分散が等しいと言える確かな理由が無ければ、最初から Welch の t 検定を使うのが今の標準的な考え方です。Zimmerman は、予備的な等分散の検定は統計学者からはもう広くは勧められていないのに、教科書やソフトに残っていると書き、2群のデータ数が違うときは無条件に Welch(分散を合算しない t 検定)を使うのがいちばん確実だと結論しています。Moser と Stevens(1992)は2標本の平均の検定で予備的な分散の検定が必要かどうかを問題にし、Ruxton(2006)と Delacre ら(2017)は Welch の t 検定を既定にするよう提案しています。Delacre らによれば、分散が本当に等しい場合でも、Welch で失う検出力はわずかです。第一種の誤りの確率も、上の表で標準偏差の比が 1 のとき 5.1% と、約束どおり 5% 前後に保たれています。
これは t 検定の記事で「Welch を基本にする」「どちらの t 検定を使うかは実験を計画する段階で決める」と書いた理由の、F 検定の側から見た説明です。Harvey の教科書のように二段階の手順を教える教科書もあるので、院試や講義の課題で「F 検定で等分散を確かめてから t 検定せよ」と指示されたら、その指示には従ったうえで、考察で「本来は最初から Welch の t 検定を使うほうがよい」と添えると理解が伝わります。
なお、ばらつきの比較そのものが目的の場合(例題1・2のように精度を比べたいとき)は、F 検定は今でも正当な道具です。批判されているのは、F 検定を「t 検定の種類を選ぶための関門」に使うことです。
F 検定は正規分布からのずれに弱い
F 検定にはもう1つ大きな弱点があります。測定値が正規分布に従わないと、実際の誤りの確率が有意水準から大きくずれることです。Box(1953)は、平均の検定(分散分析)に比べて分散の検定は正規分布からのずれにずっと弱いことを示し、分散分析の前に予備的に分散の検定をすることを、「手漕ぎボートで海に出て、大型客船が出港できるほど海が穏やかかを確かめる」ようなものだとたとえました。頑丈な客船(平均の検定)の安全を、もっと波に弱いボート(分散の検定)で確かめても意味がない、という皮肉です。
なぜ弱いのか:s2 の揺れは裾の重さで決まる
理由は、分散の推定値 s2 の揺れ方にあります。s2 の分散は、測定値の分布の尖度(裾の重さ)によって次のように変わります。
Var(s2) = σ4 [ 2/(n − 1) + γ2/n ]

γ2:超過尖度(正規分布で 0、裾が重いほど大きい)
F 分布は γ2 = 0(正規分布)のときの揺れ 2σ4/(n − 1) を前提にしている
裾の重い分布(γ2 > 0)では、ときどき大きく外れた値が出るので、s2 は正規分布を前提にした計算より大きく揺れます。その揺れが比 F にも伝わり、F 分布の臨界値を超える値が 5% より多く出ます。逆に裾の軽い分布では、F 検定は有意になりにくくなります。
しかも、データを増やしてもこのずれは消えません。上の式の2つの項はどちらも約 1/n で小さくなるので、実際の揺れと前提の揺れの比は、n が大きくなると 1 + γ2/2 という一定の値に近づきます。平均の検定(t 検定)では、データが増えるほど平均の分布が元の分布の形によらず正規分布に近づくので、前提のずれが薄まっていきます。分散にはこの救いが無いのです。Boos と Brownie(2004)も、正規分布を前提にした分散の検定の統計量は、データが多くなっても元の分布の尖度に左右されると述べています。
数値実験:外れ値が混じる測定での実際の誤りの確率
母分散が等しい2群のデータを乱数で20万組作り、両側 5% の F 検定が「有意」と出た割合を数えました。比べのため、同じデータで Welch の t 検定(平均の差を検定。母平均も等しい)の割合も示します。
| 測定値の分布 | 超過尖度 γ2 | F 検定(各10回) | F 検定(各100回) | Welch の t 検定(各10回) |
|---|---|---|---|---|
| 正規分布 | 0 | 5.0% | 5.0% | 4.8% |
| 5% の測定だけ標準偏差が3倍(ときどき大きく外れる) | 4.65 | 12.7% | 25.3% | 4.5% |
| ラプラス分布(裾が重い) | 3 | 15.8% | 20.5% | 4.4% |
| 一様分布(裾が軽い) | −1.2 | 1.1% | 0.25% | 5.0% |
20回に1回だけ大きめに外れる測定が混じるという、実験ではありがちな状況で、各10回の F 検定は 5% のつもりが 12.7% の割合で「有意」と判定します。各100回に増やすと 25.3% とさらに悪くなり、上の式から求めた極限の値(28%)に近づいていきます。同じデータでも、Welch の t 検定はほぼ 5% を保っています。F 検定で分散の違いを主張するときは、データが正規分布に近いこと、外れ値が無いことを先に確かめる必要があります。外れ値の扱いは外れ値の検定(グラブス検定とQ検定)の記事で扱います。
正規分布からのずれに強い方法:Levene 検定と Brown–Forsythe 検定
正規分布からのずれに強い等分散の検定として、Levene 検定と、その変法の Brown–Forsythe 検定があります。NIST の手引きによると、Levene 検定は各測定値と群の平均との差の絶対値を新しいデータとみなして、その平均が群の間で違うかを分散分析で調べます。Brown と Forsythe(1974)はこれを中央値(や刈り込み平均)からの差に広げ、中央値を使う版は多くの正規分布でないデータで頑健だとされています。
計算は、各値から群の中央値を引いた絶対値の列を作り、Excel の分析ツール「分散分析: 一元配置」にかけるだけです。例題1のデータでは F = 3.18、p = 0.10、例題3のデータでは F = 150、p = 2.4 × 10⁻⁷ になりました(scipy の levene 関数の center=”median” と一致)。ただし、これらの検定も「t 検定の前の関門」として使えば、上で見た二段階の問題は同じように起こります(Zimmerman が調べたのは、まさに Levene 検定を予備の検定にした手順でした)。
分散分析の F との関係
F 分布は、3群以上の平均を比べる分散分析(ANOVA)でも使われます。分散分析の F は、群の平均どうしのばらつきから求めた分散(群間の平均平方)を、群の中のばらつきから求めた分散(群内の平均平方)で割った比です。
F = 群間の平均平方 / 群内の平均平方    自由度 (群の数 − 1, 全データ数 − 群の数)

例題3のデータ(2群):群間 2.667 / 群内 0.306 = 8.71   自由度 (1, 10)   p = 0.0145
Student の t 検定:t = 2.952 → t2 = 8.71                 自由度 10    p = 0.0145
臨界値:F0.95(1, 10) = 4.965 = 2.2282(t の両側 5% 点の2乗)
2群なら、一元配置分散分析の F は Student の t の2乗にぴったり等しく、p 値も同じになります。群内の平均平方 0.306 は、t 検定の記事で求めた合算分散そのものです。つまり分散分析は、Student の t 検定を3群以上に広げたもので、「各群の母分散は等しい」という同じ前提を持っています。
同じ F 分布を使っても、等分散の F 検定と分散分析の F 検定には大きな違いがあります。分散分析は上側だけを見る片側の検定です。群の平均に差があると群間の平均平方は大きくなる一方で、差があるせいで系統的に小さくなることはないので、F が 1 より小さいことには「平均に差がある」という意味がありません。等分散の F 検定では、どちらの分散が大きくても「ばらつきが違う」ことになるので両側を見ます。この違いから、等分散の検定で使う F.INV.RT(0.025, …) と、分散分析で使う F.INV.RT(0.05, …) を取り違えないようにします。分散分析表の作り方と読み方は分散分析の記事で扱います。
よくある間違い
最初の間違いは、教科書の数表に「片側」と「両側」の両方が載っていたり、ソフトの表記が流儀によって違ったりすることから起こります。NIST の手引きも、上側の臨界値を F(α) と書くか F(1 − α) と書くかは教科書やソフトによって逆になると注意しています。記号に頼らず、「大きい方を分子にしたら、両側 α の検定には上側 α/2 の点を使う」と、確率の意味で覚えておくのが確実です。
4つ目の間違いは、レポートの考察で特によく見かけます。例題1のように標準偏差が2倍以上違っても有意にならないのは、測定回数が少なくて区別できないだけです。精度の違いを報告するときは、F と p 値に加えて、母分散の比(または標準偏差の比)の信頼区間を書くと、どこまでの違いがありうるかが読み手に伝わります。
試験・レポートでの問われ方
大学の分析化学・実験のレポートや院試では、F 検定は次のような形で問われます。
- 計算:2組のデータから分散と F を求め、数表の臨界値と比べて精度に差があるかを判定する(例題1・2)。分散を n − 1 で割ること、自由度を分子・分母の順に正しく数えること、両側か片側かで数表の確率を選ぶことが採点の分かれ目
- 両側と片側の関係:「大きい方の分散を分子にして、両側 5% で判定するときに使う臨界値はどれか」を説明させる問題
- t 検定との組み合わせ:「2つの平均を比べる前に何を確かめるか」。教科書の手順としては F 検定で等分散を確かめることが答えになるが、Welch の t 検定なら等分散の前提が要らないことまで書けると評価が上がる
- F が比になる理由:母分散が等しいとき、比をとると未知の σ が消えて、自由度だけで分布が決まることを説明できるか
- 分散分析との関係:2群の一元配置分散分析の F が Student の t の2乗になること
実験レポートで2つの方法や2人の結果のばらつきを比べるときは、「Bの方がばらつきが大きかった」と書く代わりに、F 検定の結果と標準偏差の比の信頼区間を添えると、考察が一段具体的になります(考察の書き方は実験レポートの書き方)。精度がどの作業から来ているかを分けて見積もるときは誤差の伝播の記事、分析法の精度を検出限界と合わせて評価するときは検出限界と定量限界の記事が役に立ちます。3つ以上の方法や試験室を比べるなら、2つずつ F 検定や t 検定を繰り返すのではなく、分散分析の記事の方法を使います。
まとめ
F 検定の式は、「2つのばらつきの比が、偶然の揺れで説明できる範囲か」という1つの問いを数にしたものです。そして分散は、平均よりずっと大きく、しかも分布の形に敏感に揺れます。この見方を持っていれば、臨界値が 1 から遠い理由も、二段階のやり方が勧められない理由も、外れ値に弱い理由も、同じ1本の筋で説明できます。
よくある質問
F 検定は、2つのデータの分散の比 F = s12/s22 を求め、F 分布と比べて、2つの母分散(ばらつき・精度)に差があるかを判定する方法です。母分散が等しければ F は 1 の近くに出ます。F 分布の形は、分子の自由度(データ数 − 1)と分母の自由度の2つで決まります。分析化学では、2つの分析法や2台の装置の精度を比べるときに使います。
F を 1 以上にそろえると、上側の臨界値1つと比べるだけで両側検定ができるからです。F 分布では、下側の臨界値が、分子と分母の自由度を入れ替えた上側の臨界値の逆数になります。そのため、小さい方を分子にした F が下側の臨界値より小さいことと、大きい方を分子にした F が上側の臨界値より大きいことは同じ意味です。このとき両側 5% の検定に使うのは上側 2.5% 点で、上側 5% 点と比べると実際には両側 10% の検定になります。
F.TEST(配列1, 配列2) は2つのデータ範囲から直接、両側の p 値を返し、配列の順番を入れ替えても同じ値になります。F.DIST.RT(x, 自由度1, 自由度2) は F が x より大きくなる右側の確率を返すので、1 以上の F と分子・分母の順の自由度を渡し、両側の p 値にするには2倍します。F.INV.RT(確率, 自由度1, 自由度2) は臨界値を返し、両側 5% の検定には確率に 0.025 を入れます。F.DIST.RT と F.INV.RT は、自由度の小数部が切り捨てられます。
必要ありません。2群の分散が等しいと言える確かな理由が無ければ、最初から Welch の t 検定を使うのが勧められています。少ない回数の F 検定は分散の違いを見逃しやすく、F 検定の結果で Student と Welch を選ぶ二段階のやり方では、第一種の誤りの確率が 5% に保たれないことがシミュレーションで示されています。Welch の t 検定は、分散が本当に等しい場合でも失う検出力がわずかです。
言えません。有意でないことは、そのデータの量では分散の違いを見分けられなかったことを意味するだけです。たとえば5回ずつの測定では、本当に標準偏差が2倍違っても、両側 5% の F 検定が有意になる確率は約21%しかありません。「精度に有意な差があるとはいえない」と書き、母分散の比の信頼区間を添えて、どこまでの違いがありうるかを示します。
参考文献
- D. Harvey, Analytical Chemistry 2.1, §4.6 Statistical Methods for Normal Distributions(LibreTexts)
- NIST/SEMATECH, e-Handbook of Statistical Methods, §1.3.5.9 F-Test for Equality of Two Variances、§1.3.5.10 Levene Test for Equality of Variances、§1.3.6.6.5 F Distribution
- D. W. Zimmerman, “A note on preliminary tests of equality of variances”, British Journal of Mathematical and Statistical Psychology 2004, 57, 173–181
- B. K. Moser, G. R. Stevens, “Homogeneity of Variance in the Two-Sample Means Test”, The American Statistician 1992, 46, 19–21
- M. Delacre, D. Lakens, C. Leys, “Why Psychologists Should by Default Use Welch’s t-test Instead of Student’s t-test”, International Review of Social Psychology 2017, 30, 92–101
- G. D. Ruxton, “The unequal variance t-test is an underused alternative to Student’s t-test and the Mann–Whitney U test”, Behavioral Ecology 2006, 17, 688–690
- G. E. P. Box, “Non-normality and tests on variances”, Biometrika 1953, 40, 318–335
- D. D. Boos, C. Brownie, “Comparing Variances and Other Measures of Dispersion”, Statistical Science 2004, 19, 571–578
- M. B. Brown, A. B. Forsythe, “Robust Tests for the Equality of Variances”, Journal of the American Statistical Association 1974, 69, 364–367
- Microsoft サポート「F.TEST 関数」「F.DIST.RT 関数」「F.INV.RT 関数」「F.DIST 関数」「分析ツールを使用して統計学的および工学的分析を行う」
- GraphPad, “How to compare two means when the groups have different standard deviations”(FAQ 1349)
関連記事
機器分析の全体像は機器分析総まとめ、実験操作は有機化学実験の基本操作まとめにまとめています。
- t検定のやり方とp値の意味|対応のある・ないの使い分けとExcelのT.TEST
- 標準偏差と標準誤差の違いとは?n-1で割る理由・相対標準偏差と変動係数
- 分散分析とは?一元配置のやり方と分散分析表の読み方|F値・p値とExcel
- 外れ値の検定|グラブス検定とQ検定のやり方・臨界値と捨ててよい条件
- 誤差の伝播とは?不確かさの計算式と合成標準不確かさ・滴定の計算例
- 検出限界と定量限界の違いと求め方|S/N比・3.3σ/S・分析法バリデーション
- 最小二乗法とは?傾きと切片の式の導出・標準誤差・決定係数とExcelの関数
- 実験レポートの書き方|テンプレートと考察の例文【有機化学実験の記入例】